Aprendizaje por refuerzo y metabolómica: dónde encaja y dónde no
¿Usarías el aprendizaje por refuerzo con datos de metabolómica? Hoy en día se puede usar todo para todo, y las limitaciones técnicas que existían hace apenas unos pocos años cada vez pesan menos. En este momento, mi respuesta corta sería que sí se puede, pero probablemente no en el lugar que nos vendría primero a la mente. El motivo tiene más que ver con el calendario que con el algoritmo. Comencemos.
El aprendizaje por refuerzo (RL, por sus siglas en inglés) es la rama del machine learning que aprende a tomar decisiones en secuencia. Un agente observa un estado, elige una acción y recibe una recompensa. Y comienza otra vez. Tras muchas iteraciones, aprende una política, es decir, una serie de reglas que le indican qué hacer en cada situación para maximizar la recompensa acumulada a largo plazo. Estos modelos son interesantes porque, a diferencia del aprendizaje supervisado, no necesitan que les digamos cuál es la respuesta correcta. Les basta con saber después si les fue bien o mal. De ahí su atractivo en medicina y en nutrición, donde muchas veces no sabemos cuál es la «dosis correcta» para una persona concreta, pero sí podemos medir cómo responde.
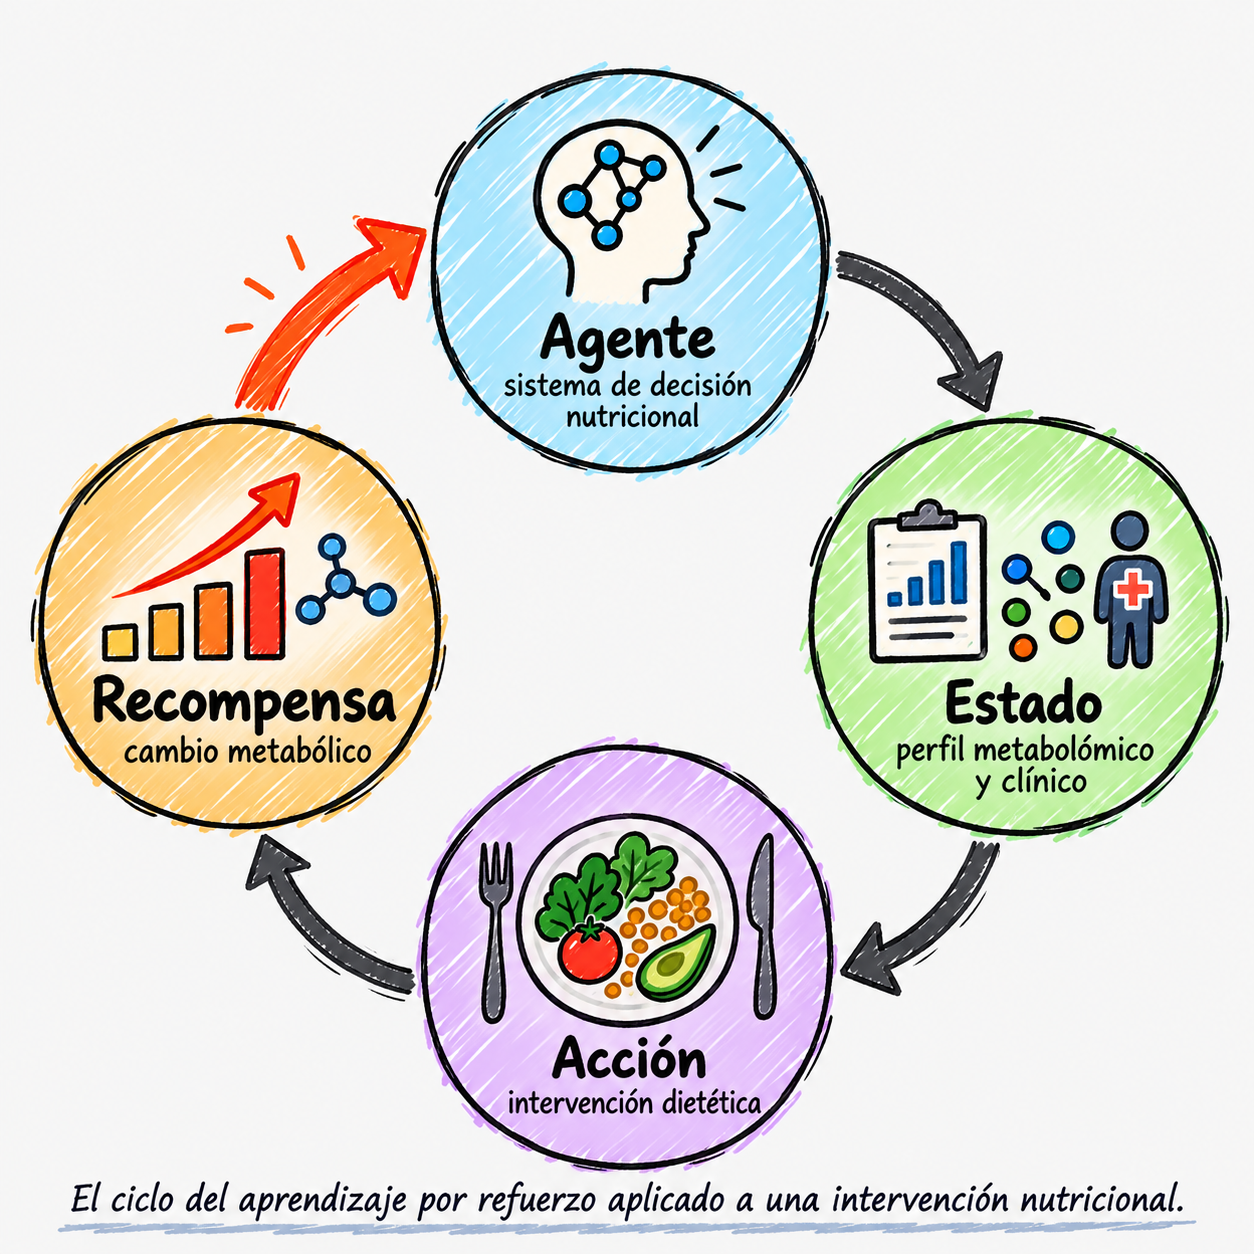
¿Y si usamos el perfil metabolómico como estado del paciente, la dieta como acción y la mejora metabólica como recompensa? A pesar de que la idea me parece genial, hoy por hoy, posiblemente sea irrealizable. Veamos por qué y dónde, en mi opinión, sí podría tener sentido.
¿Qué necesita un agente para aprender?
Fácil. Retroalimentación frecuente. Los ejemplos clínicos que han funcionado hasta ahora tienen eso en común. Por ejemplo, en un ensayo publicado en Nature Medicine en 2023, un grupo de Shanghái entrenó un sistema de RL basado en un modelo con los registros de 12.981 pacientes hospitalizados con diabetes tipo 2, en los que la glucemia capilar se recogía en siete momentos del día. El sistema aprendió a ajustar la dosis de insulina.
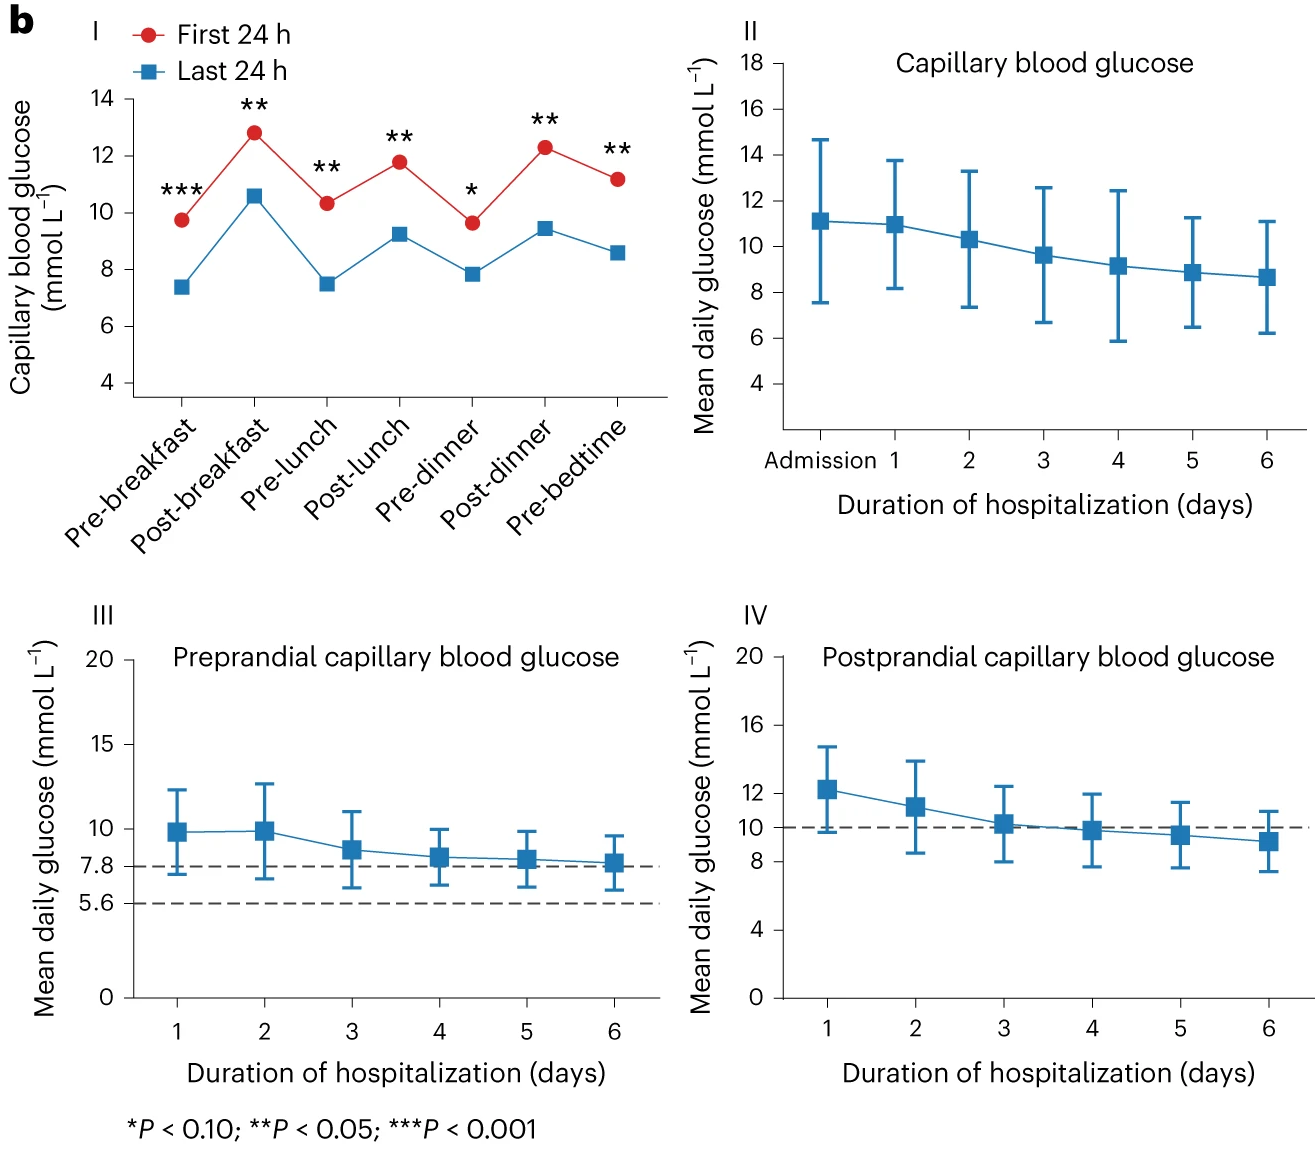
Este estudio tiene letra pequeña y conviene leer bien el diseño. Es un ensayo de un solo brazo que compara las primeras 24 horas con las últimas en pacientes que acababan de ingresar, precisamente para controlar la glucemia (posiblemente cualquier protocolo razonable mejore ese perfil tras cinco días de hospitalización), pero es una prueba de viabilidad razonable (no debemos confundirla con su eficacia). Otro trabajo hizo algo parecido en 15 adultos con diabetes tipo 1. En este caso personalizó la insulina para comidas ricas en grasa y para el ejercicio posprandial durante 16 semanas, también con un único brazo.
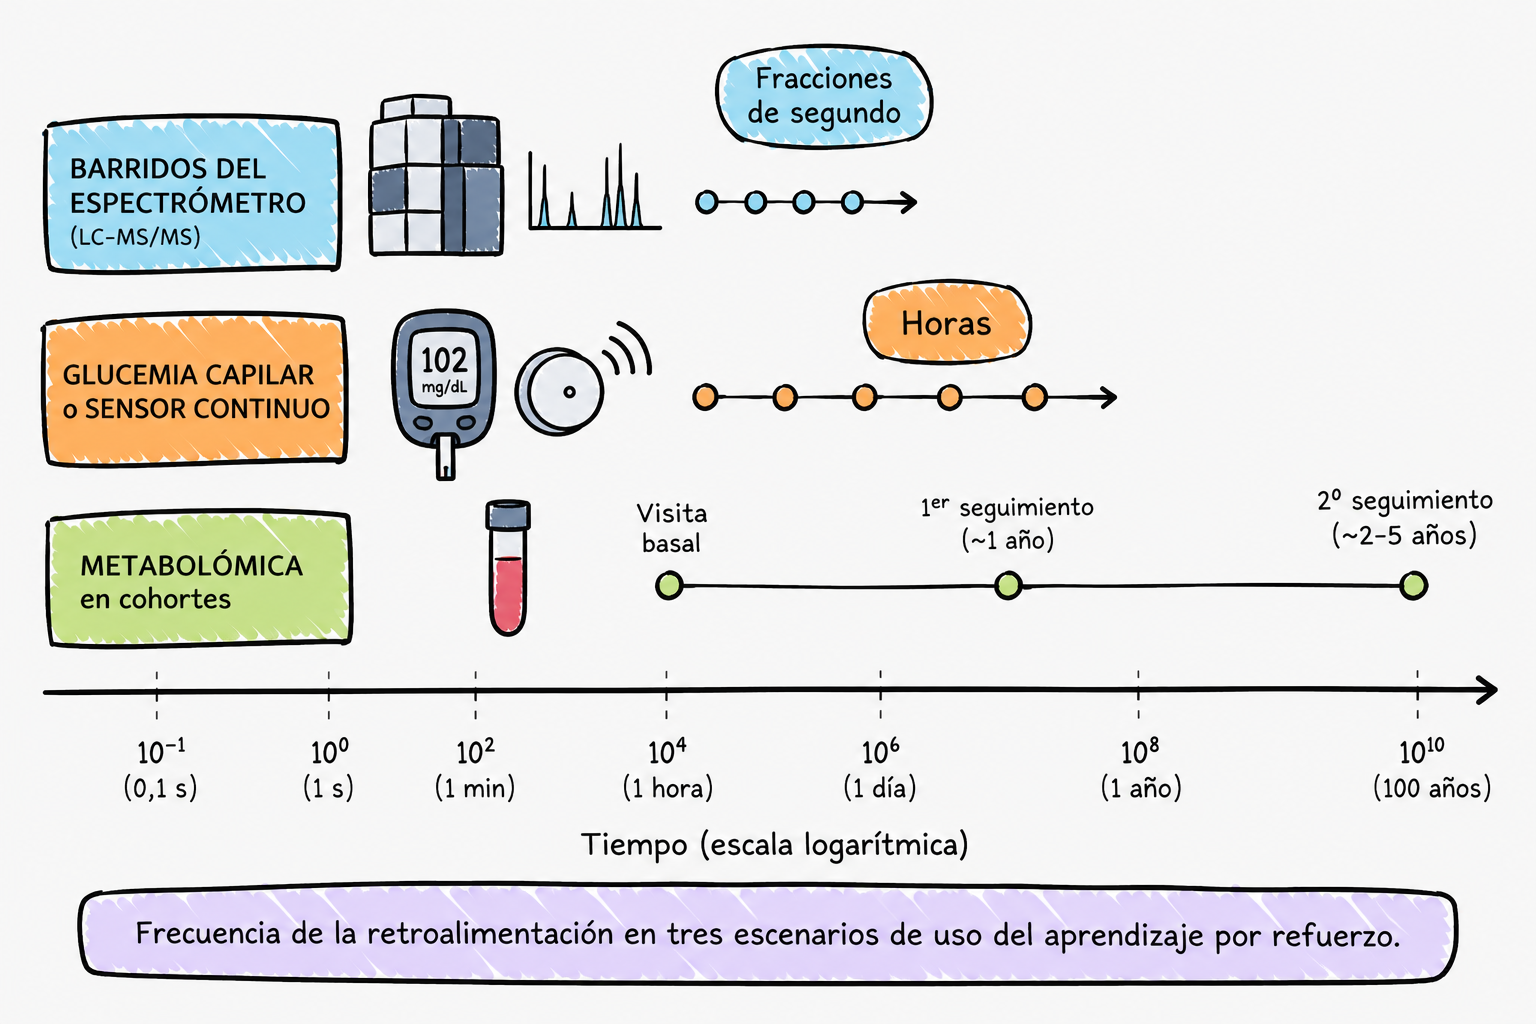
En ambos estudios lo interesante es el andamiaje. La glucosa se mide varias veces al día o de forma continua con un sensor, y la recompensa llega horas después de la acción. En el estudio de Shanghái, el agente disponía de casi 120.000 días de tratamiento con siete puntos de glucemia cada uno. Una muestra considerable mucho mayor de lo que normalmente tenemos nosotros en muchas cohortes nutricionales, donde la metabolómica se mide en la visita basal y, con suerte, en una o dos visitas de seguimiento separadas por años.
En estas situaciones, el agente, como mucho, aprende un promedio, pero no tiene suficientes datos para aprender una política.
¿Dónde sí encaja?
Con esta introducción, más bien tirando a la inutilidad de estos modelos, dado que la metabolómica es lenta como fuente de recompensa, abro el camino a dos situaciones en las que el RL tendría interés: donde el propio proceso analítico genere retroalimentación densa, o donde la metabolómica sea el contexto y la recompensa proceda de otra medida. Comencemos con los ejemplos.
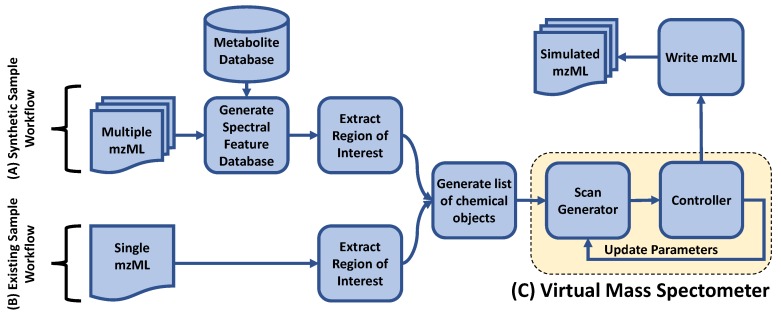
- En metabolómica no dirigida por LC-MS/MS, el instrumento decide en tiempo real qué iones fragmentar. La estrategia más habitual, la adquisición dependiente de datos Top-N, fragmenta los N iones más intensos de cada barrido MS1 y deja fuera buena parte de lo que hay en la muestra (y, en general, lo que más nos interesa suele estar en la cola de baja abundancia). Es un problema de decisiones secuenciales. Cada fracción de segundo hay que elegir una acción, y la recompensa, un espectro MS2 de calidad para un metabolito aún no fragmentado, llega casi de inmediato. Antes, la limitación de este ejemplo era el coste de entrenar en tiempo real un agente con un instrumento. Pero desde hace un tiempo tenemos herramientas como el simulador ViMMS, desarrollado en Glasgow, que reproduce una inyección de LC-MS/MS in silico para probar estrategias de fragmentación antes de tocar el equipo. Su versión 2.0 ya permite ejecutar los mismos controladores sobre instrumentos reales y hay grupos, como uno de la Universidad de Amberes, que ya trabajan en combinar redes que predicen la calidad de los espectros con RL offline para explorar configuraciones del instrumento. Hasta donde sé, todavía no hay un trabajo en una revista de primer nivel que demuestre una ganancia sostenida en muestras biológicas reales (y por eso lo trataría, por tanto, como una línea abierta más que como una herramienta), pero todo hace pensar que es cuestión de tiempo que se desarrolle un sistema logística y económicamente viable.
- En ingeniería metabólica, la optimización de cepas sigue el ciclo DBTL, y la metabolómica (o, al menos, la cuantificación del producto y de sus intermediarios) es la medida de la fase de test. Un trabajo en PLOS Computational Biology propuso un RL multiagente que ajusta los niveles de enzimas sin conocer la red metabólica. Aprovecha que, en una placa multipocillo, cada pocillo puede actuar como un agente que explora en paralelo. Lo validaron en un modelo cinético a escala genómica de E. coli, utilizado como sustituto de la célula, y en datos públicos de una librería combinatoria de levadura productora de L-triptófano. La lección trasladable del diseño experimental es que, cuando no puedes medir con mayor frecuencia, puedes medir más en paralelo.
- Otro ejemplo en el que, además, tengo bastante interés, es la anotación de metabolitos desconocidos. Aquí, el agente decide sobre una molécula, añade átomos y enlaces y recibe como recompensa cuánto se parece el espectro simulado de su candidato al espectro observado. Para este ejemplo tenemos el modelo MSNovelist con un enfoque generativo que no usa refuerzo, sino que acertó la estructura en primera posición en el 25 % de 3.863 espectros de GNPS. Hasta donde he investigado, es una línea que aún está en desarrollo, pero cualquiera que haya trabajado con base de datos de MS/MS seguramente ha tenido miles de picos sin identificar y, técnicamente, inútiles a la hora de trabajar su parte biológica. Hablé de ello hace unas semanas.
¿Y en nutrición de precisión?
Volvamos a la tentación inicial, porque tiene arreglo si se reformula. La metabolómica puede entrar como estado de partida o como contexto. Un perfil basal de aminoácidos de cadena ramificada, acilcarnitinas o TMAO podría determinar con qué intervención empieza cada persona (en términos técnicos, un bandit contextual). La recompensa la aportaría una señal densa, como la glucosa, el peso semanal o la adherencia registrada en una aplicación. Es el mismo andamiaje de los ensayos con insulina, pero con un estado más rico.
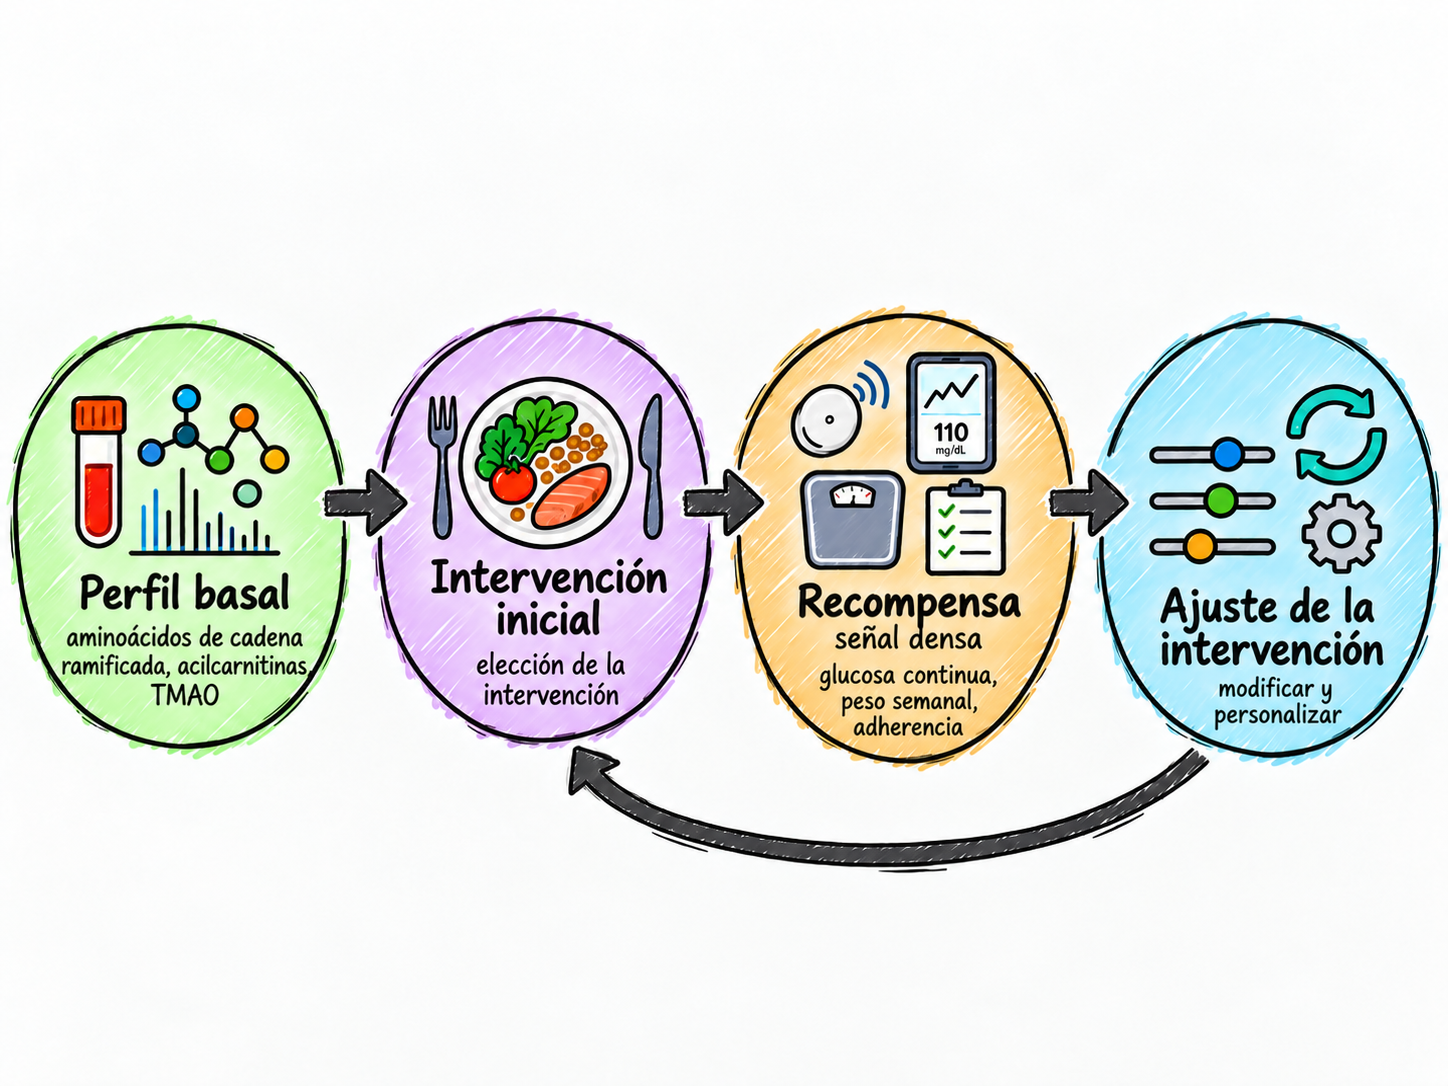
También puede entrar como recompensa a un horizonte de largo plazo, pero entonces estamos optimizando un biomarcador sustituto y, como sabemos, los sustitutos en nutrición hay que considerarlos con prudencia. Disminuir los niveles de un metabolito no garantiza mejorar el desenlace que nos interesa. Un agente que lo optimiza lo hará con una eficacia que difícilmente un profesional igualaría, pero también lo hará cuando el camino no tenga sentido fisiológico, hecho que no nos interesa.
La otra vía es el RL offline sobre cohortes o ensayos ya realizados, que es lo que haría la mayoría de los grupos de epidemiología nutricional. Aquí los problemas son los de siempre, con otro nombre. El agente aprende de las decisiones que tomaron l@s dietistas o l@s propi@s participantes, y si esas decisiones dependían de aspectos no registrados, la confusión y el sesgo formarían parte directamente de la política.
Las guías publicadas para el uso de estos modelos en salud insisten precisamente en ello (recomiendo su lectura antes de entrenar nada). Piden comprobar que el estado contenga lo que motivó cada decisión, desconfiar de las políticas que se alejan mucho de lo observado y tratar con cautela las evaluaciones ajenas a la política. Un ejemplo reciente ilustra el riesgo. En este preprint se entrenó un agente (DeepEN) para la nutrición enteral en la UCI con más de 11.000 pacientes de la base de datos MIMIC-IV y consiguió una reducción de la mortalidad del 22,8 % al 18,8 %. Es una mortalidad estimada por el propio procedimiento de evaluación, que no se ha observado en ningún ensayo.
Para acabar, también añadiría un problema propio de la metabolómica y del que aún no he hablado mucho: la variabilidad intraindividual. Muchos metabolitos tienen una reproducibilidad a medio plazo modesta, de modo que dos mediciones separadas por un año captan tanto cambios biológicos como ruido analítico y de muestreo. Un agente no sabe distinguir ese ruido de una respuesta a la acción y es bastante probable que aprenda a perseguirlo, lo que, en términos generales, implica entrenar a un agente sobreentrenado.
¿Por dónde empezaría?
Para este caso, diría que el orden de las preguntas importa más que el algoritmo.
- ¿Dónde está la retroalimentación densa del problema? Si no la hay, probablemente lo que necesitamos es un buen ensayo adaptativo o un modelo de efectos heterogéneos, y no un agente.
- ¿Qué papel juega la metabolómica? Puede ser un estado, un contexto o una recompensa. Si es una recompensa, hay que preguntarse hasta qué punto constituye un buen sustituto del desenlace real.
- ¿Existe un simulador creíble? Puede ser ViMMS para el espectrómetro, un modelo cinético para la cepa o un modelo del paciente como el de los ensayos con insulina. Lo importante es contar con un entorno en el que el agente pueda equivocarse miles de veces sin coste.
En los ejemplos que funcionan, las tres respuestas estaban claras antes de escribir una línea de código. Al final, el refuerzo aprende de sus errores y la pregunta útil será cada cuánto tiempo sabremos que nos hemos equivocado. En el espectrómetro, lo podemos saber en fracciones de segundo, pero en una cohorte puede suponer años. ¿Estamos dispuestos a comprobarlo? Otra buena pregunta.