Cómo elegir un modelo en medicina de precisión según los datos y lo que se quiere saber
La medicina de precisión parte de una premisa sencilla: dos pacientes con el mismo diagnóstico pueden tener, por dentro, enfermedades distintas, con mecanismos moleculares diferentes y, por tanto, necesitar tratamientos distintos. Para determinar o caracterizar esos subgrupos, combinamos ciencias ómicas, datos clínicos, estilo de vida y exposiciones, y ahí es donde entra la inteligencia artificial.
La pregunta "¿qué algoritmo uso?" aparece enseguida en cualquier proyecto de este tipo, y la respuesta es el ya conocido "depende de los datos que tengas y de lo que quieras saber". No es lo mismo predecir que explicar, ni una matriz de 20.000 genes y 200 pacientes que una historia clínica con miles de pacientes y huecos por todas partes (real-world data). En este post repaso los modelos más usados y para qué pregunta dirijo cada uno.
Paso 1: los datos
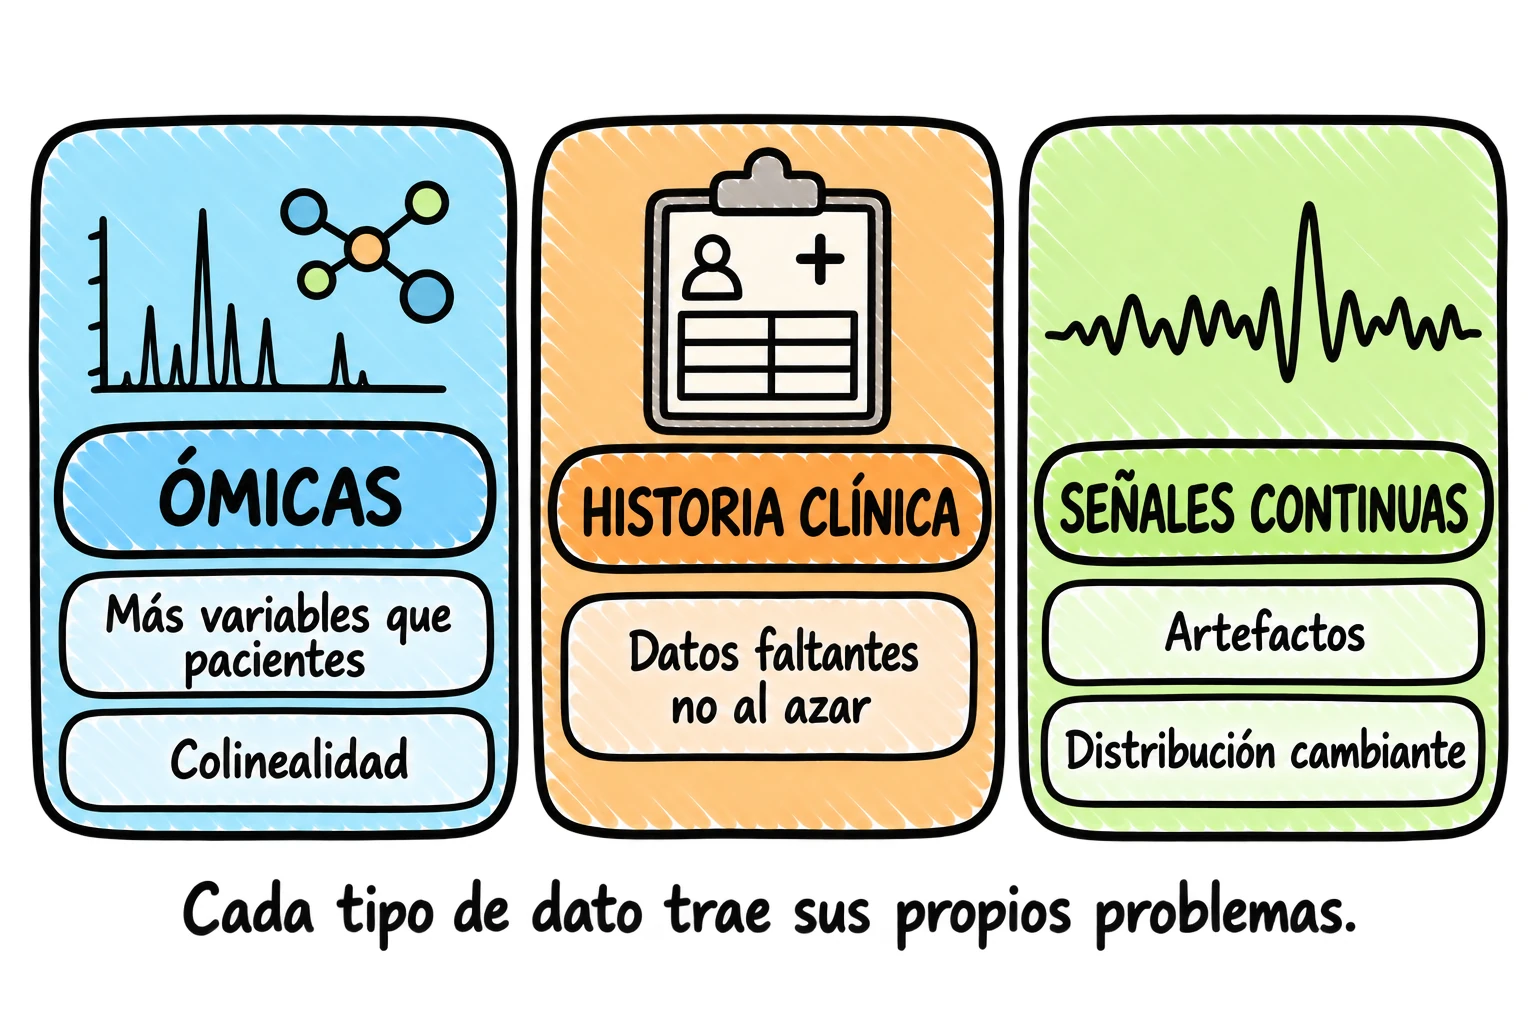
Antes de decidir y aplicar el algoritmo, conviene saber con qué se trabaja, porque cada tipo de dato trae sus propios problemas. Los datos ómicos tienen más dimensiones de características (variables) que de observaciones (por ejemplo, pacientes), suelen tener mucho ruido técnico y las características están muy correlacionadas (genes co-regulados, metabolitos de una misma ruta...). La historia clínica electrónica mezcla datos estructurados y texto libre, variables categóricas con muchísimos niveles y fechas que no deberían tratarse como texto, sino como "tiempo desde el último evento". Y, sobre todo, tiene muchos (muchísimos) datos que están ausentes no de forma aleatoria, sino porque el/la clínic@ correspondiente no consideró necesaria una prueba determinada, y eso ya es información (imputar con la media, por ejemplo, aquí, introduce sesgos). Las señales continuas de la UCI o de los dispositivos portátiles, por su parte, son series temporales llenas de artefactos cuya distribución cambia con el tiempo, por ejemplo, cuando el paciente empeora.
Paso 2.1: si quieres seleccionar biomarcadores...
Con datos ómicos no se puede usar la regresión lineal clásica por la colinealidad de los datos y la opción más similar es la regresión regularizada. Tenemos tres opciones:
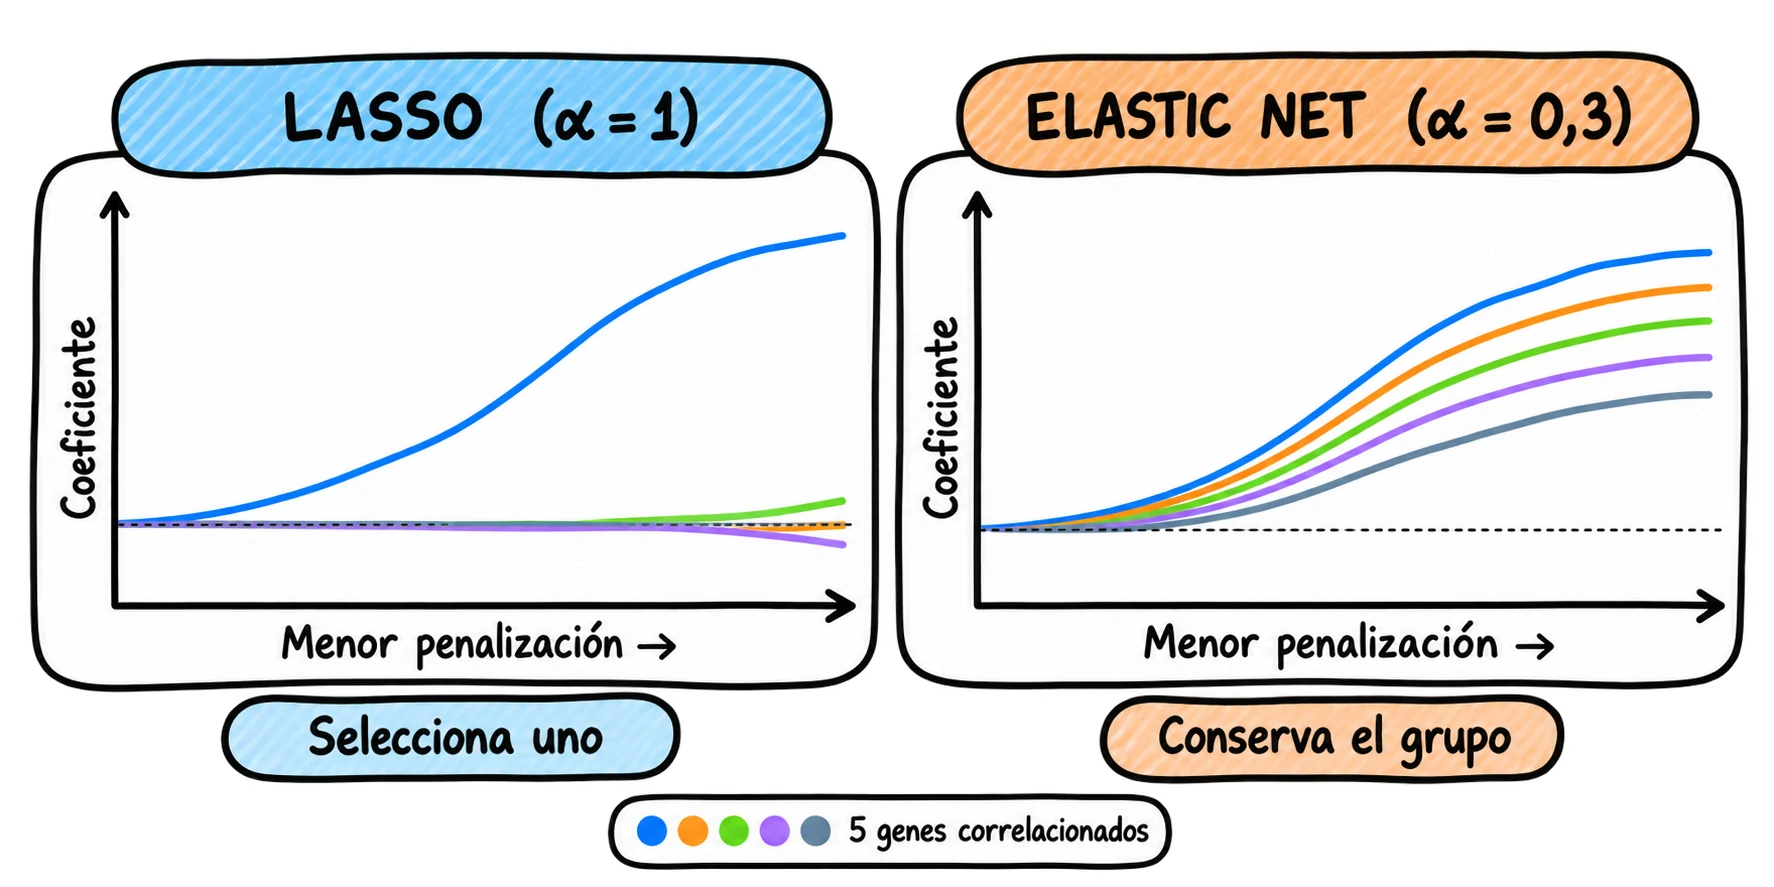
- Lasso lleva coeficientes a cero y selecciona variables, pero con variables muy correlacionadas tiende a quedarse con una casi al azar e ignorar las demás, lo cual, biológicamente, es un problema (si todo un grupo de genes de una ruta es relevante, quedarse con uno es arbitrario).
- Elastic net combina Lasso y Ridge (si alguna persona ha revisado mi bibliografía, sabrá que es un modelo que uso con frecuencia): la parte de Ridge reparte el peso entre variables correlacionadas y la de Lasso sigue descartando el ruido, así que permite identificar grupos enteros de genes, metabolitos o proteínas. Su versión adaptativa pondera la penalización con una estimación inicial para no encoger de más los efectos grandes y, en teoría y con suficientes datos, selecciona las variables verdaderas como si se supiera de antemano cuáles son. En la práctica, eso sí, la ganancia no está garantizada. En una comparación de predicción genómica, ni las versiones adaptativas ni las agrupadas mejoraron claramente a las simples y los modelos lineales mixtos y regularizados siguen entre los más eficientes. Se usa para predecir fenotipos tumorales, integrar datos de múltiples ómicas o realizar predicciones genómicas con miles de SNPs. En R, el paquete de referencia es
glmnet, aunque también se puede usarcaret.
library(glmnet)

set.seed(2026)

n <- 80
z <- rnorm(n)

# Cinco genes altamente correlacionados
genes <- sapply(1:5, function(j) {
  z + rnorm(n, sd = 0.08)
})

# Variables sin señal
ruido <- matrix(rnorm(n * 15), n)

x <- scale(cbind(genes, ruido))
y <- 1.5 * z + rnorm(n, sd = 0.5)

lambda <- exp(seq(log(2), log(0.01), length.out = 100))

lasso <- glmnet(x, y, alpha = 1, lambda = lambda)
enet  <- glmnet(x, y, alpha = 0.3, lambda = lambda)

par(mfrow = c(1, 2))

plot(lasso, xvar = "lambda", main = "Lasso")
plot(enet, xvar = "lambda", main = "Elastic net")
Paso 2.2: si quieres predecir con datos tabulares
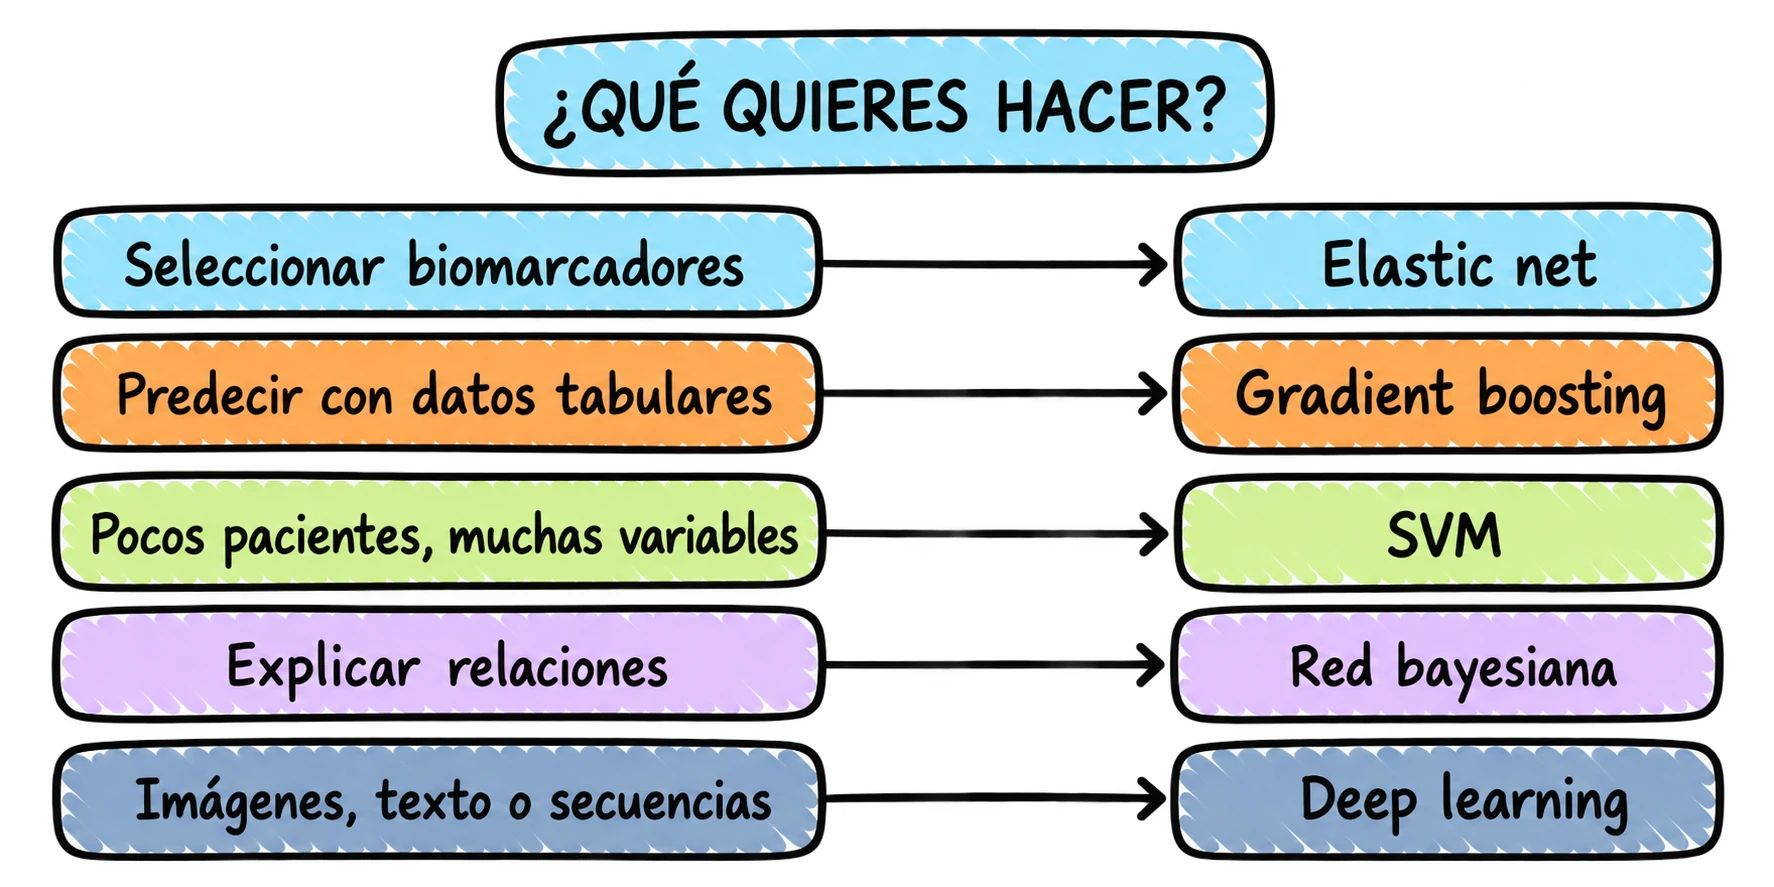
Los modelos basados en árboles manejan bien las interacciones no lineales y los datos mixtos sin necesidad de escalarlos, por lo que están presentes en toda la investigación clínica.
- Random forest construye muchos árboles independientes y promedia sus resultados; resiste bien el sobreajuste y proporciona una medida de la importancia de cada variable, lo que resulta útil para la exploración.
- El gradient boosting (XGBoost, LightGBM, CatBoost) construye árboles uno tras otro, cada uno corrigiendo los errores del anterior. Suele predecir mejor en conjuntos de datos grandes y maneja los valores faltantes de forma nativa, lo cual es muy útil en la historia clínica.
Eso sí, "suele predecir mejor" no significa que siempre lo haga. En un estudio de predicción de osteoporosis en personas mayores con alto riesgo cardiovascular, con 211 participantes, la regresión logística (AUC de 0,75) quedó por delante de las máquinas de vectores de soporte, random forest, XGBoost y los árboles de decisión. Con pocos datos tabulares, lo simple suele ser más eficiente y rápido que recurrir a modelos de machine learning.
Paso 2.3: si tienes pocos pacientes y muchas variables
Las máquinas de vectores de soporte buscan la frontera que separa las clases con el máximo margen y funcionan incluso cuando hay más variables que muestras, lo que las convirtió durante años en el estándar de la bioinformática (subtipos de cáncer por expresión génica o neuroimagen).
El algoritmo de los k vecinos más cercanos, en cambio, es muy intuitivo y útil para imputar valores al buscar pacientes similares, pero sufre mucho con la alta dimensionalidad. Con miles de variables, el vecino más cercano y el más lejano están a distancias casi iguales. Sin una selección previa de variables, con ómicas no funciona bien (de esto hablaré en otro post).
Paso 2.4: si quieres explicar, no solo predecir
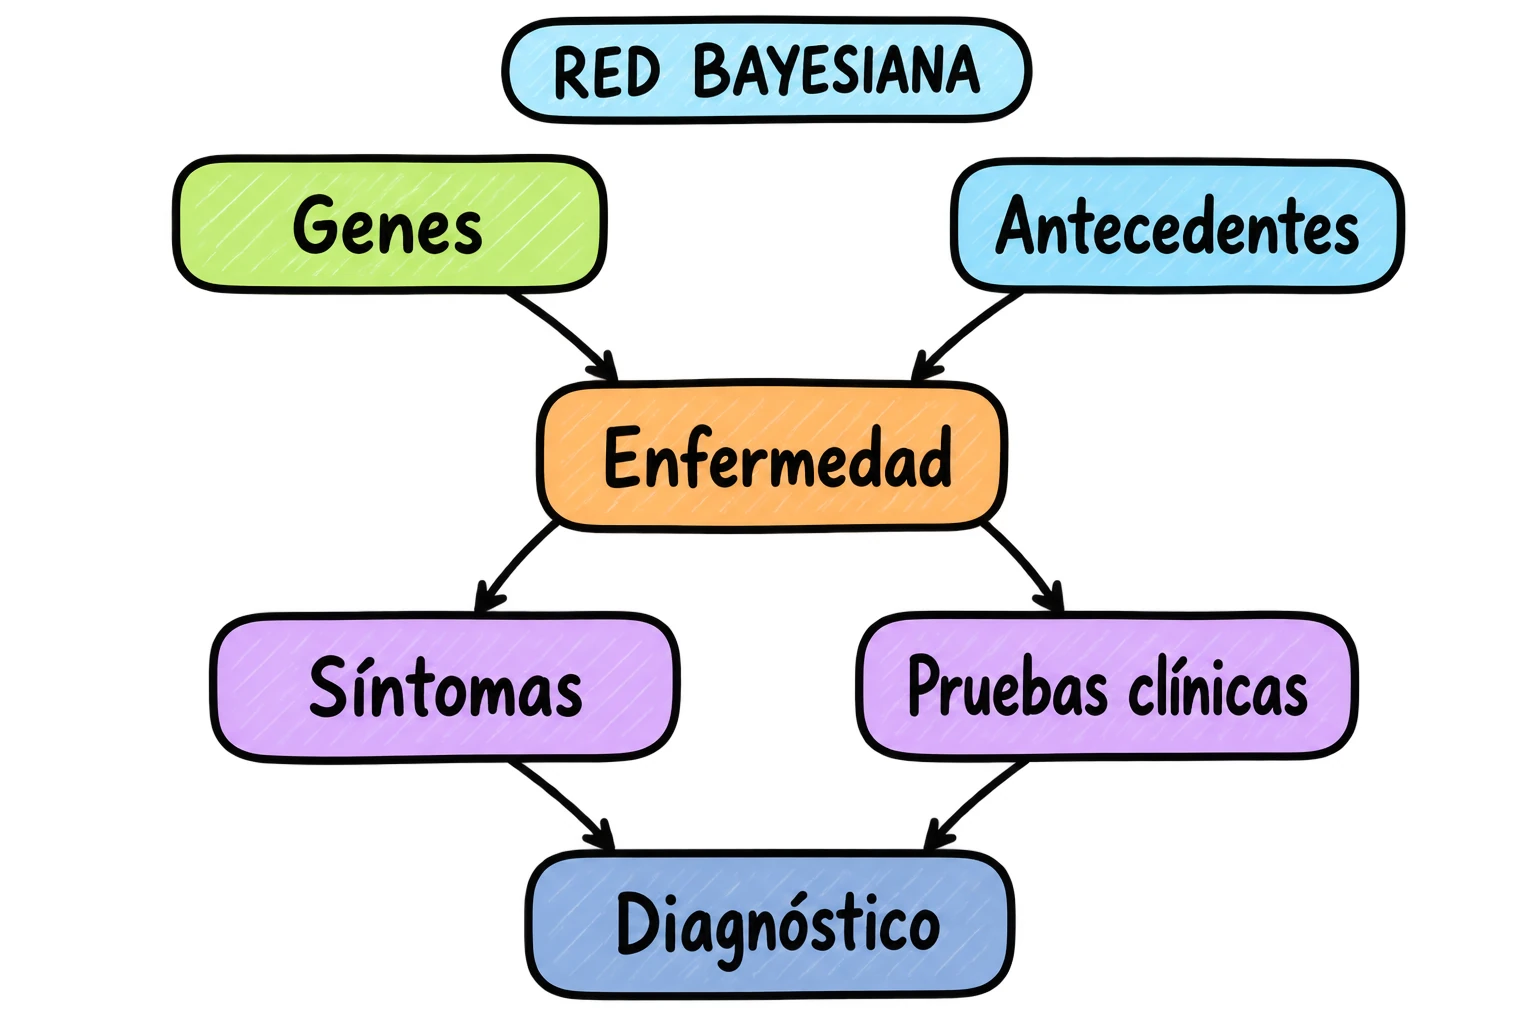
El deep learning destaca en la predicción, pero las redes bayesianas destacan en la explicación. Son grafos en los que los nodos representan variables (síntomas, genes y enfermedades) y las flechas, dependencias condicionales. Permiten actualizar la probabilidad de un diagnóstico a medida que llega nueva información y, si el grafo se construye con conocimiento causal, simular intervenciones del tipo "¿qué pasa si damos el fármaco X?". Además, manejan los datos faltantes sin necesidad de imputación. Se han usado en sistemas de apoyo al diagnóstico y, por ejemplo, para predecir la respuesta a la inmunoterapia en cáncer de pulmón no microcítico, con un modelo de "caja blanca" que, además de ser más preciso que los métodos previos, permite ver qué variables influyen en cada predicción.
Paso 2.5: si trabajas con imágenes, texto o secuencias
Aquí el aprendizaje profundo no tiene rival. Las redes convolucionales (CNN) para histopatología o retinopatía diabética, las redes recurrentes (RNN) para electrocardiogramas o historias longitudinales, los autoencoders para comprimir miles de genes en un espacio latente y las redes de grafos para predecir propiedades moleculares. Su gran pega es la interpretabilidad. Una salida intermedia interesante son los árboles de decisión suaves: se entrena una red compleja y se "destila" su conocimiento en un árbol que imita sus predicciones, pero cuya lógica se puede inspeccionar.
Y si los datos no paran de llegar, como en la monitorización continua, hacen falta algoritmos de clustering en flujo que den más peso a los datos recientes para detectar cambios agudos. En Python, la biblioteca River es la referencia para el aprendizaje incremental y en R, el paquete stream.
¿R o Python?
La gran pregunta. Depende de lo que hagas. R sigue dominando el análisis estadístico, la bioinformática con Bioconductor y la visualización, con implementaciones muy rigurosas como glmnet. Python es más fuerte en deep learning, en producción y con modelos preentrenados. Para la interpretabilidad hay herramientas en ambos: DALEX en R y SHAP en Python.
Un resumen simple
Si vais a elegir un modelo, os propondría este orden.
- La pregunta: ¿predecir, seleccionar biomarcadores, explicar un mecanismo o descubrir subgrupos?
- Los datos: cuántos pacientes y cuántas variables, cuántos datos faltan y por qué, si son estáticos o llegan en flujo.
- El modelo más simple que responda a esa pregunta, comparado siempre con una regresión logística o con un modelo regularizado. Si un XGBoost o una red no supera claramente a esa referencia en una validación externa, la complejidad no justifica el beneficio.
Un modelo que predice la sepsis a la perfección, pero no explica por qué, tiene poco recorrido en un entorno en el que el médico necesita entender la fisiopatología. En medicina de precisión, el mejor algoritmo no es el más potente, sino el que responde a la pregunta clínica con datos auditables.