Modelos de lenguaje en bioestadística: contexto, soberanía de los datos y verificación
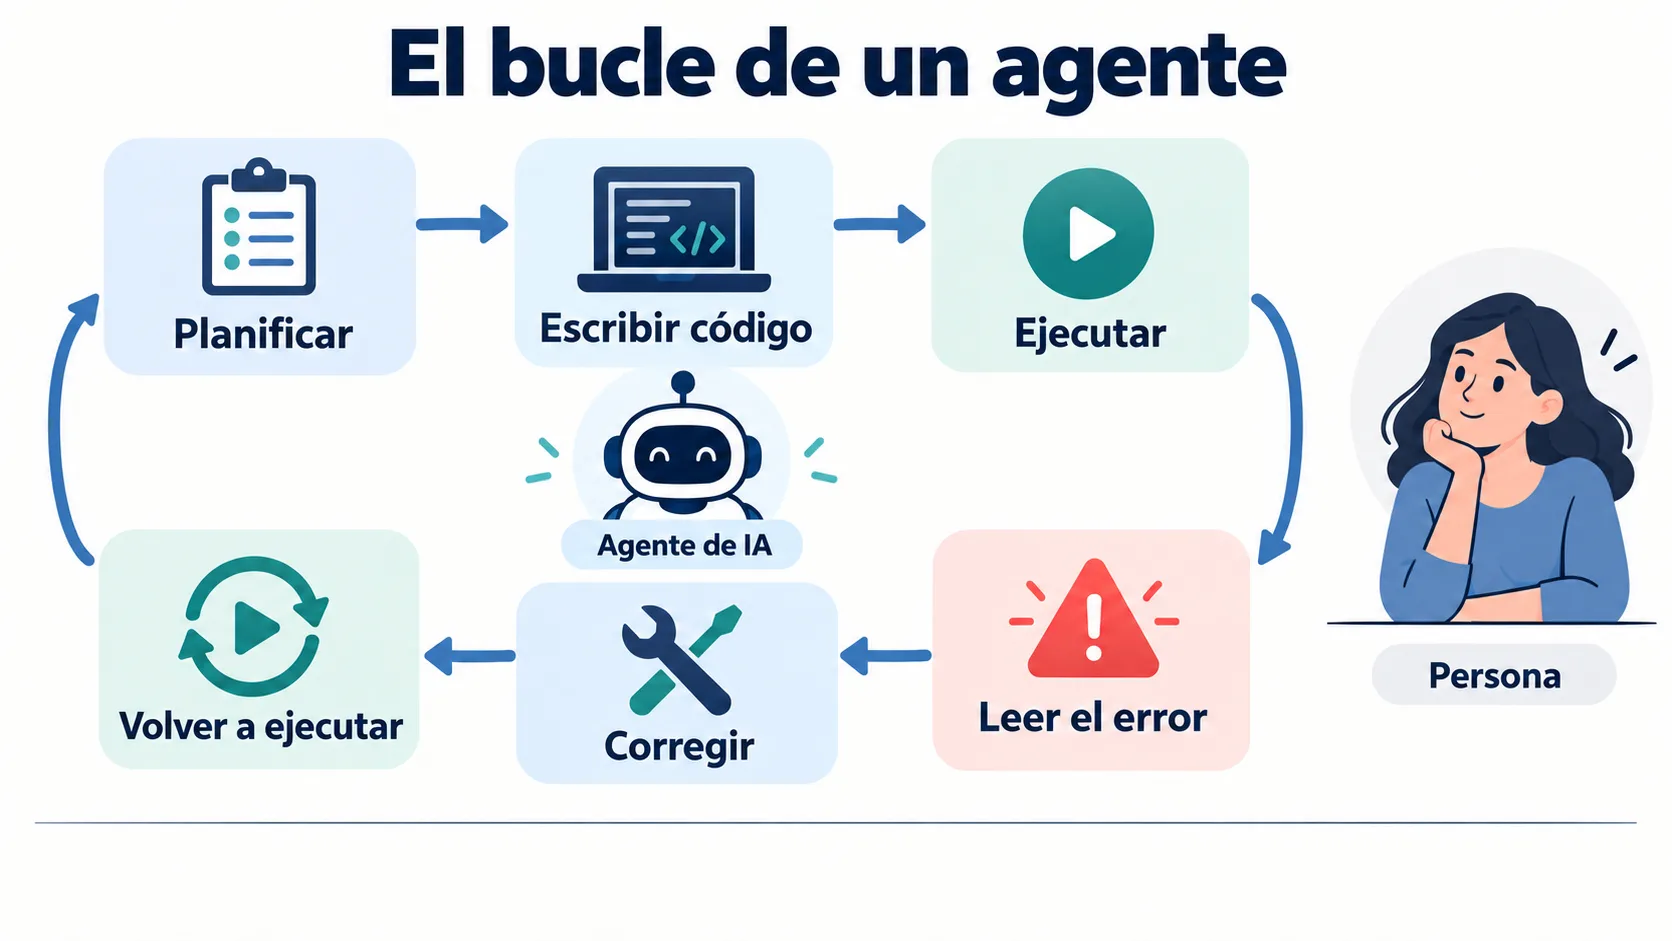
Hace no tanto, usábamos los modelos de lenguaje como un buscador con buena capacidad de conversación: preguntabas, respondía y hasta ahí. Este año, cualquiera que haya decidido utilizar IA para agilizar tareas estará de acuerdo en que ya no funcionan así. Los modelos actuales actúan como agentes que planifican un análisis, escriben el código, lo ejecutan en una terminal, leen el error, lo corrigen y vuelven a ejecutar, a veces durante horas y sin que nadie intervenga. En otro post escribí sobre los riesgos de programar por intuición con estas herramientas. Vayamos un paso más allá: ¿qué pasa cuando las usamos en bioestadística, con datos de pacientes y de ómicas?
Un panorama que cambia cada mes
A día de hoy, en noviembre de 2026, el mercado está partido en dos. Por un lado, los modelos cerrados occidentales, que solo funcionan a través de la nube de su proveedor: la familia GPT-6 de OpenAI, con Astra como modelo más potente y Sol y Luna como versiones más baratas; Claude Opus 5.5 de Anthropic, muy orientado a la programación con agentes; y Gemini 4 Argon de Google, centrado en la ingeniería de software y en tareas científicas complejas. Por otro lado, los modelos de pesos abiertos, sobre todo asiáticos, que se pueden descargar e instalar en servidores propios: DeepSeek V4.1, la familia Qwen 3.8 de Alibaba y Kimi K3 de Moonshot AI.
La novedad de esto es que los segundos ya compiten de verdad con los primeros en programación, y eso, como veremos, puede ser muy interesante para quien trabaja con datos clínicos y recursos limitados. Hay que tener en cuenta que estas cifras caducan en semanas (probablemente, cuando leáis esto, ya haya otra generación), pero lo que no lo hace son los problemas de fondo.
El millón de tokens
Todos los grandes modelos anuncian ventanas de contexto de alrededor de un millón de tokens. La ventana de contexto, para quien no lo sepa, es la memoria de trabajo del modelo, la cantidad máxima de texto que puede tener delante a la vez para generar una respuesta. Ahí entra desde nuestras instrucciones y los documentos que le pasamos hasta sus respuestas y, en el caso de los agentes, el historial de todo lo que ya han hecho. Lo que no cabe no existe. Se mide en tokens, los fragmentos de palabras con los que trabaja el modelo (una palabra suele ocupar uno o dos tokens), así que un millón de tokens equivale a varios cientos de miles de palabras. Se podría crear un contexto con todo un ensayo clínico completo, sus anexos y decenas de artículos. Pero leer no es lo mismo que relacionar.
Encontrar un dato concreto escondido en un millón de tokens ("la aguja en el pajar") está prácticamente resuelto: ya en mayo de este año, una evaluación independiente daba un 100 % de aciertos a los principales modelos cerrados. El problema surge cuando hay que encontrar varios datos dispersos y relacionarlos, que es justo lo que hacemos en biomedicina al conectar una mutación descrita en las primeras páginas con un efecto adverso oculto en una tabla suplementaria cientos de páginas después. Para la generación actual, las cifras de esa tarea con un millón de tokens las ponen, de momento, los propios fabricantes: OpenAI anuncia más de un 96 % para GPT-6 Astra cuando tiene que recuperar ocho datos repartidos entre el medio millón y el millón de tokens, y Google, un 84 % para Gemini 4 Argon en una prueba que obliga a seguir las conexiones de un grafo descrito a lo largo de todo el texto, frente al 72 % de GPT-6 Astra. Anthropic no publica ninguna cifra de este tipo para Claude Opus 5.5. En nuestro campo, que quien vende el producto sea quien firma el ensayo es lo que se llama conflicto de interés.
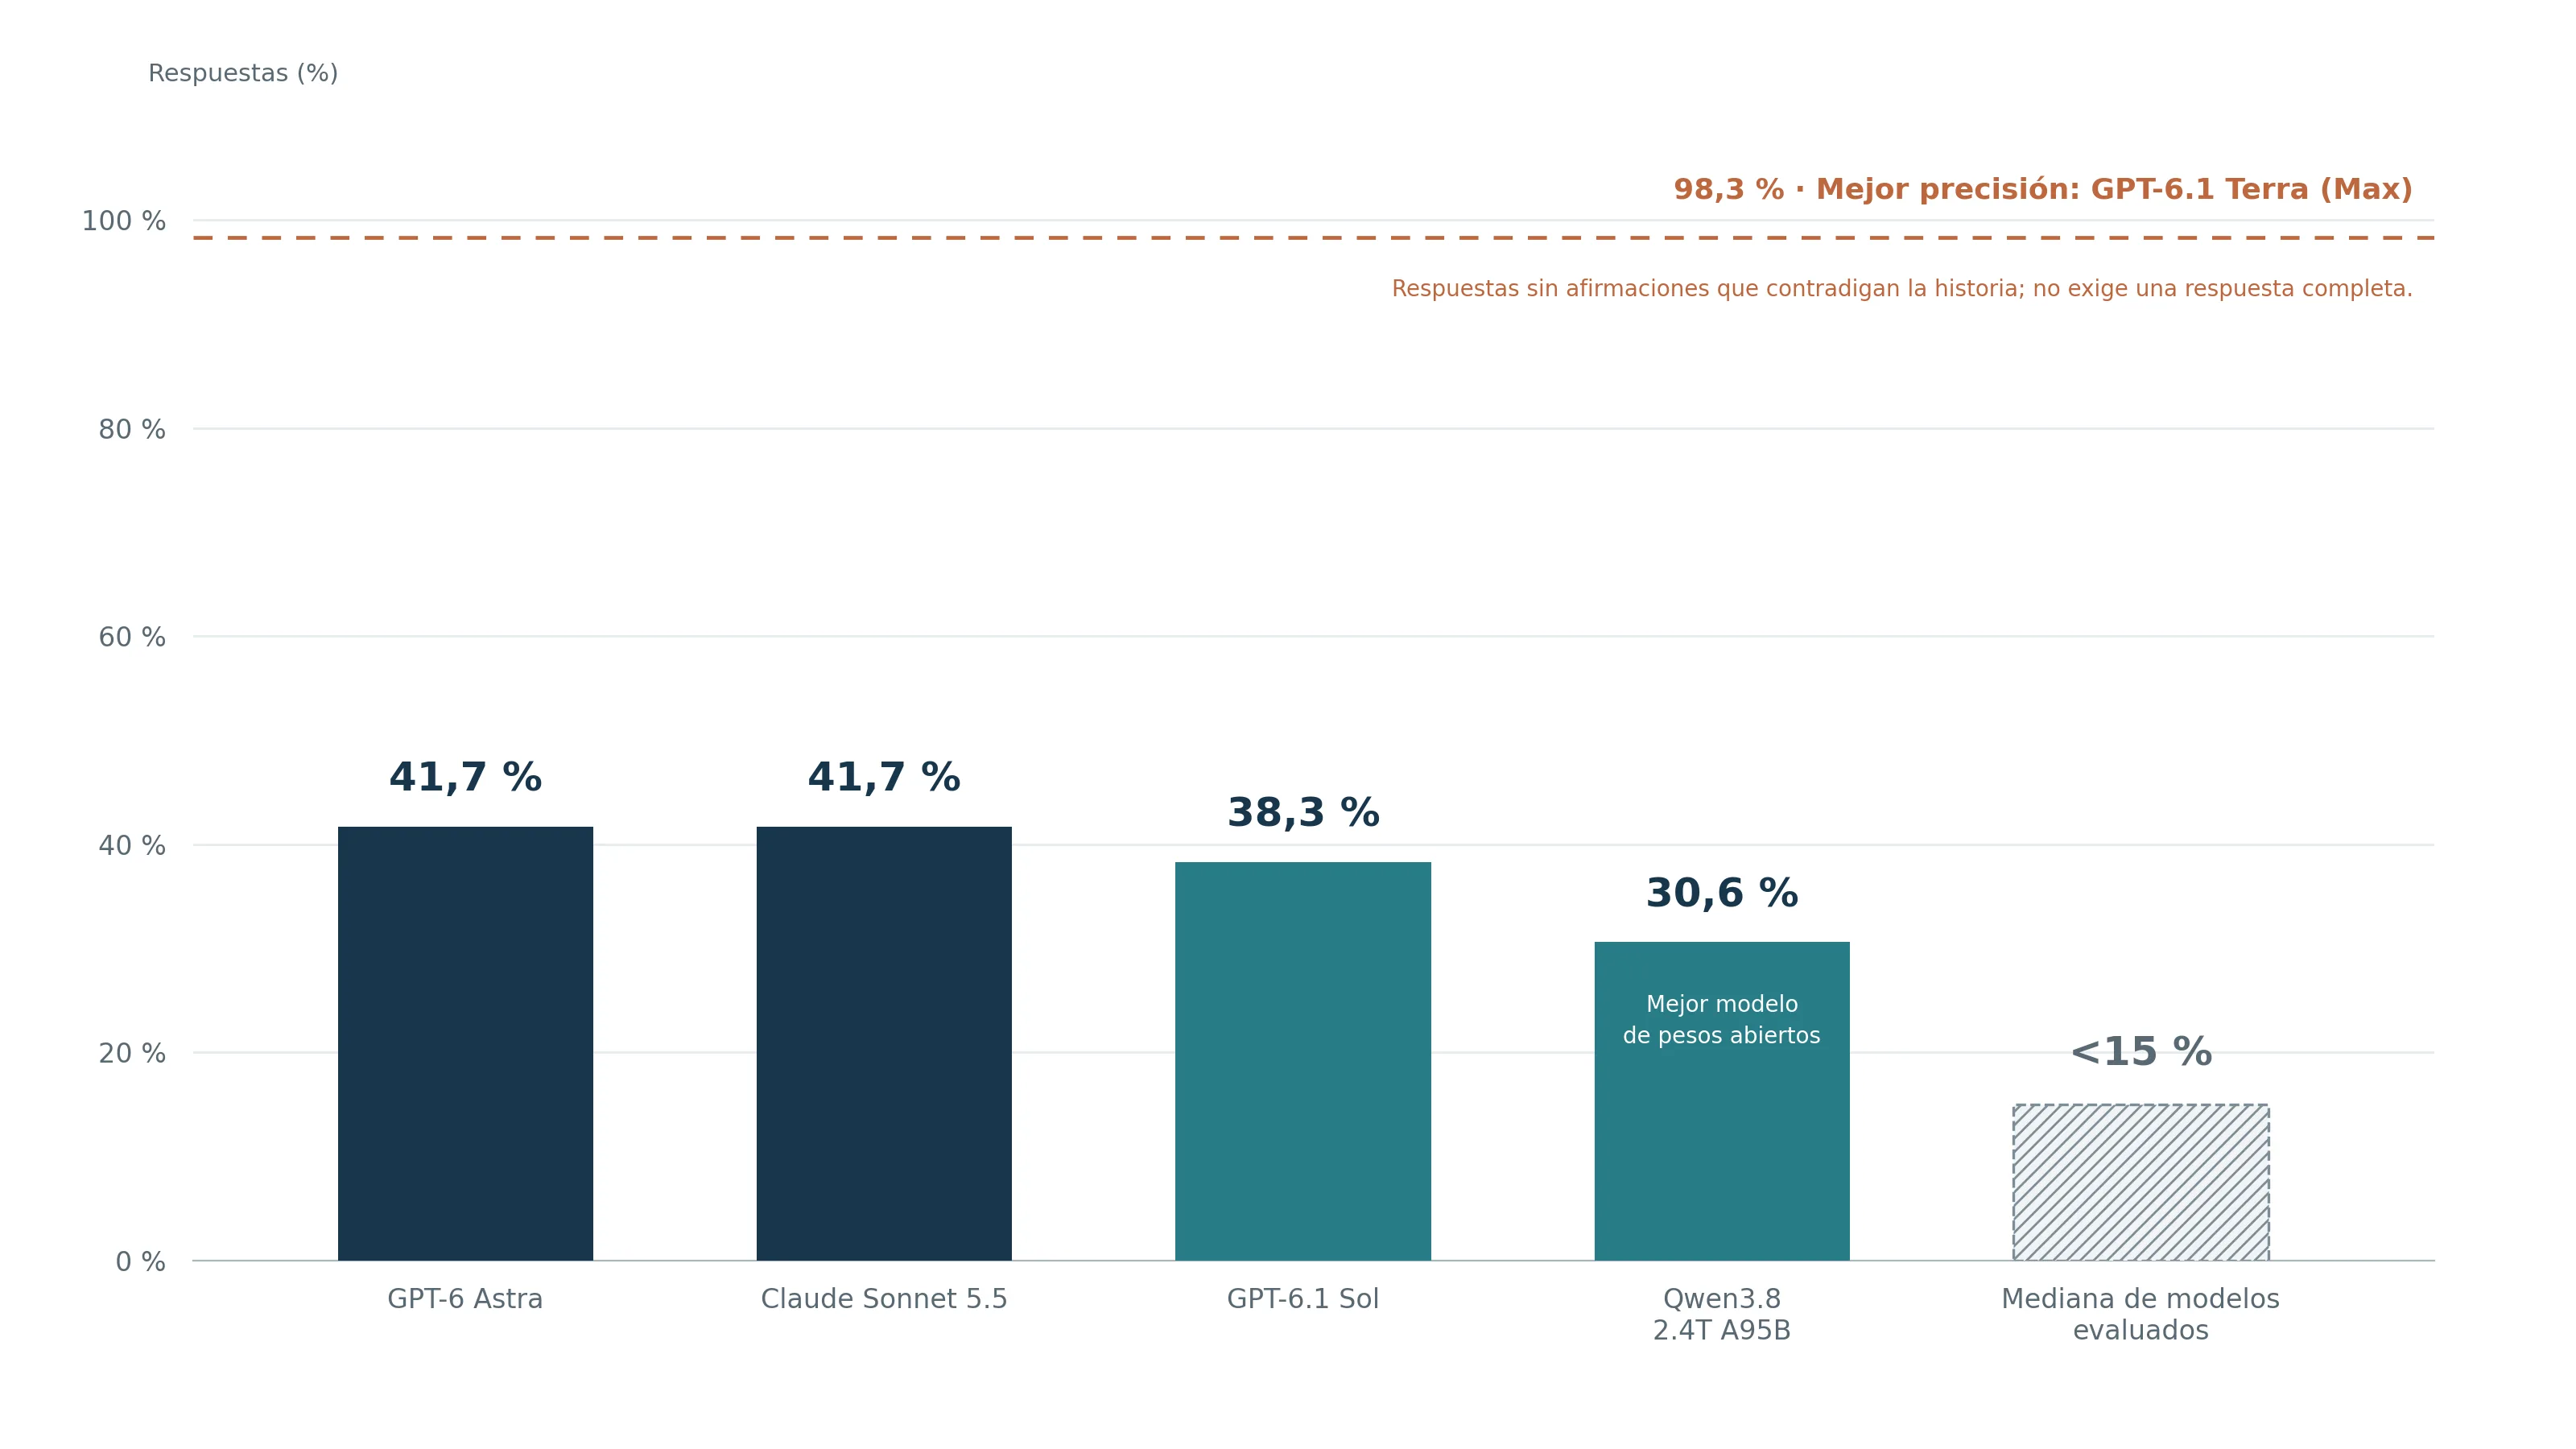
La única evaluación independiente con modelos actuales que he encontrado proviene, además, de nuestro propio terreno. MLCR-AA, de Artificial Analysis y Wisedocs, pide a los modelos que razonen sobre historias clínicas sintéticas. Por ejemplo, reconstruir la cronología de un tratamiento repartida en varios informes o decidir si una lesión se explica mejor por un accidente laboral o por una enfermedad previa. En la actualización del 21 de octubre, GPT-6 Astra y Claude Sonnet 5.5 empatan en cabeza con un 41,7 % de respuestas completas y sin contradicciones con la historia. El mejor modelo abierto, Qwen3.8 2.4T A95B, se queda en torno al 31 %, y la mediana de todos los evaluados no alcanza el 15 %. Esas historias clínicas tienen entre 25.000 y 64.000 tokens, entre quince y cuarenta veces menos que lo que cabe en la ventana. Lo que nos está indicando eso es que la longitud de la ventana determina cuánto puede leer el modelo, no cuánto puede relacionar (y que a estas empresas les interesa más vender que mostrar números reales).
El script que compila
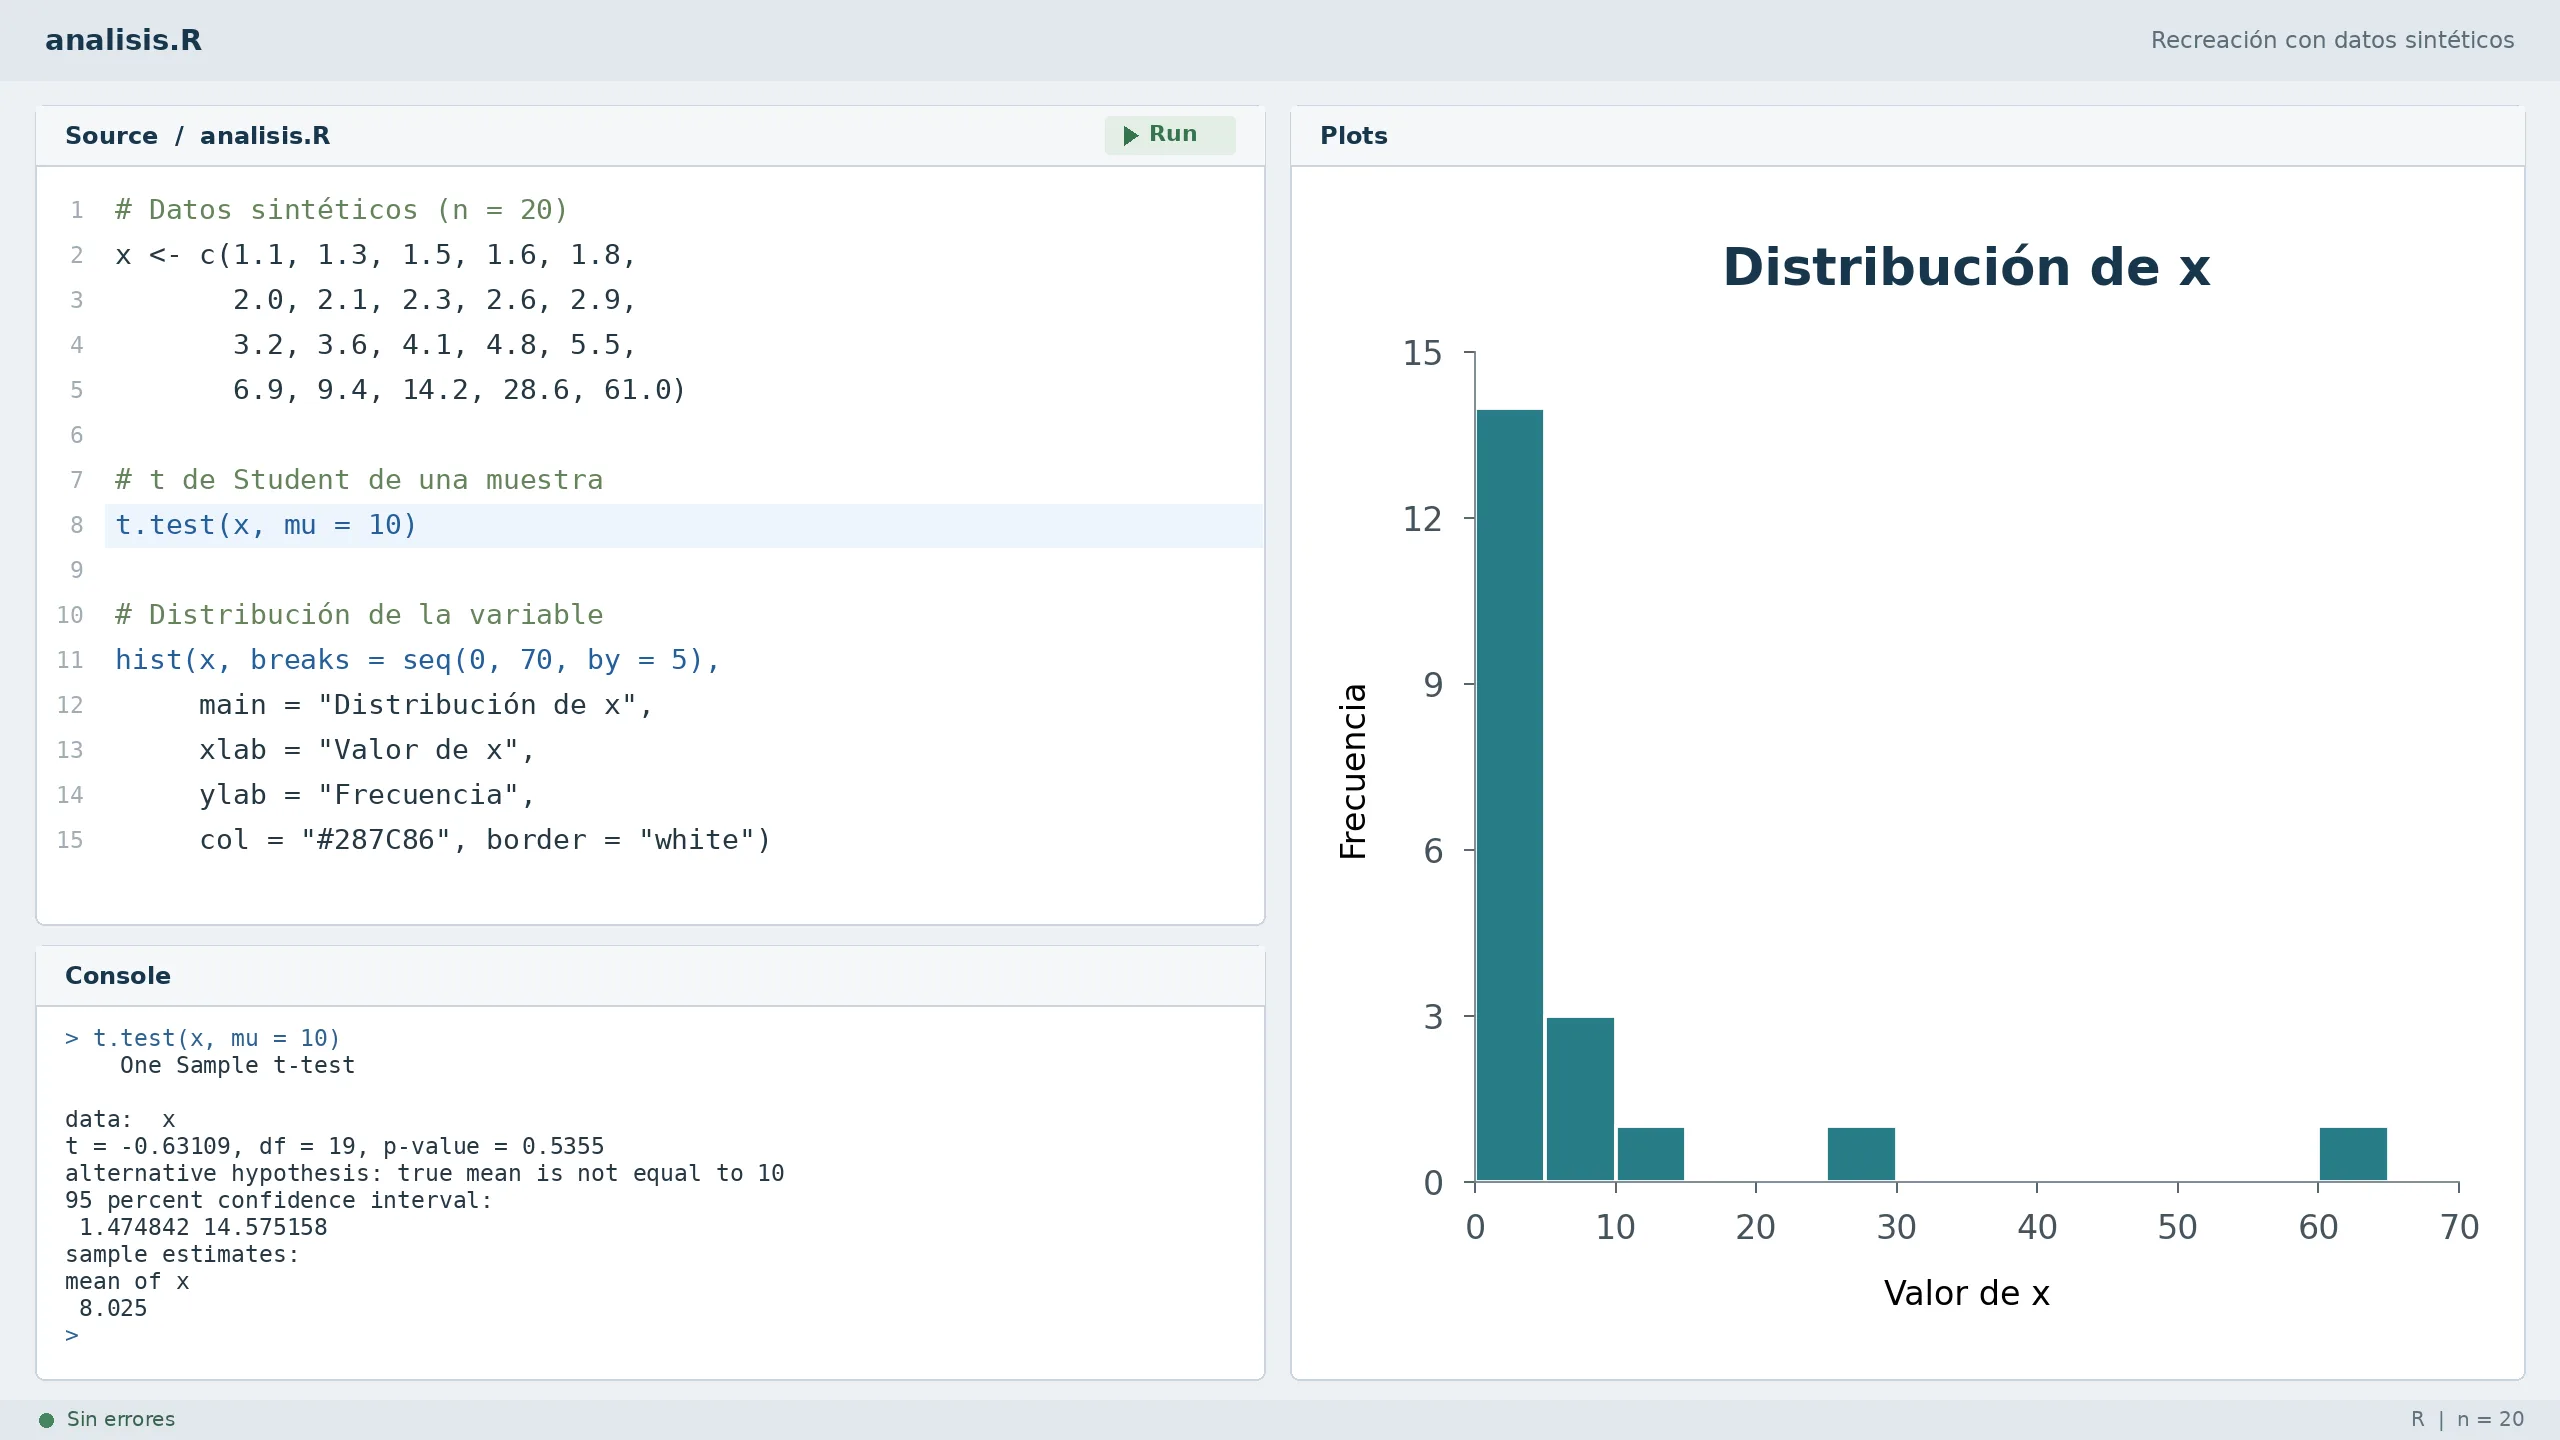
El problema más serio, para mí, es que un agente puede escribir un script de R impecable, que se ejecuta sin un solo error, comprobar su funcionamiento y decirte que es genial y no tiene errores, y aun así estar mal. Puede corregir los efectos de lote de forma incorrecta o aplicar una t de Student a variables genómicas muy asimétricas asumiendo normalidad. El código funciona, pero lo que falla es la ciencia detrás. El resultado es una lista de biomarcadores llena de falsos positivos en un paper que, si tenemos suerte, morirá en el mar de papers iguales y, si no, formará parte de un conjunto de datos erróneos que potenciará la pérdida de tiempo, dinero y otros recursos al investigar algo que no tiene recorrido.
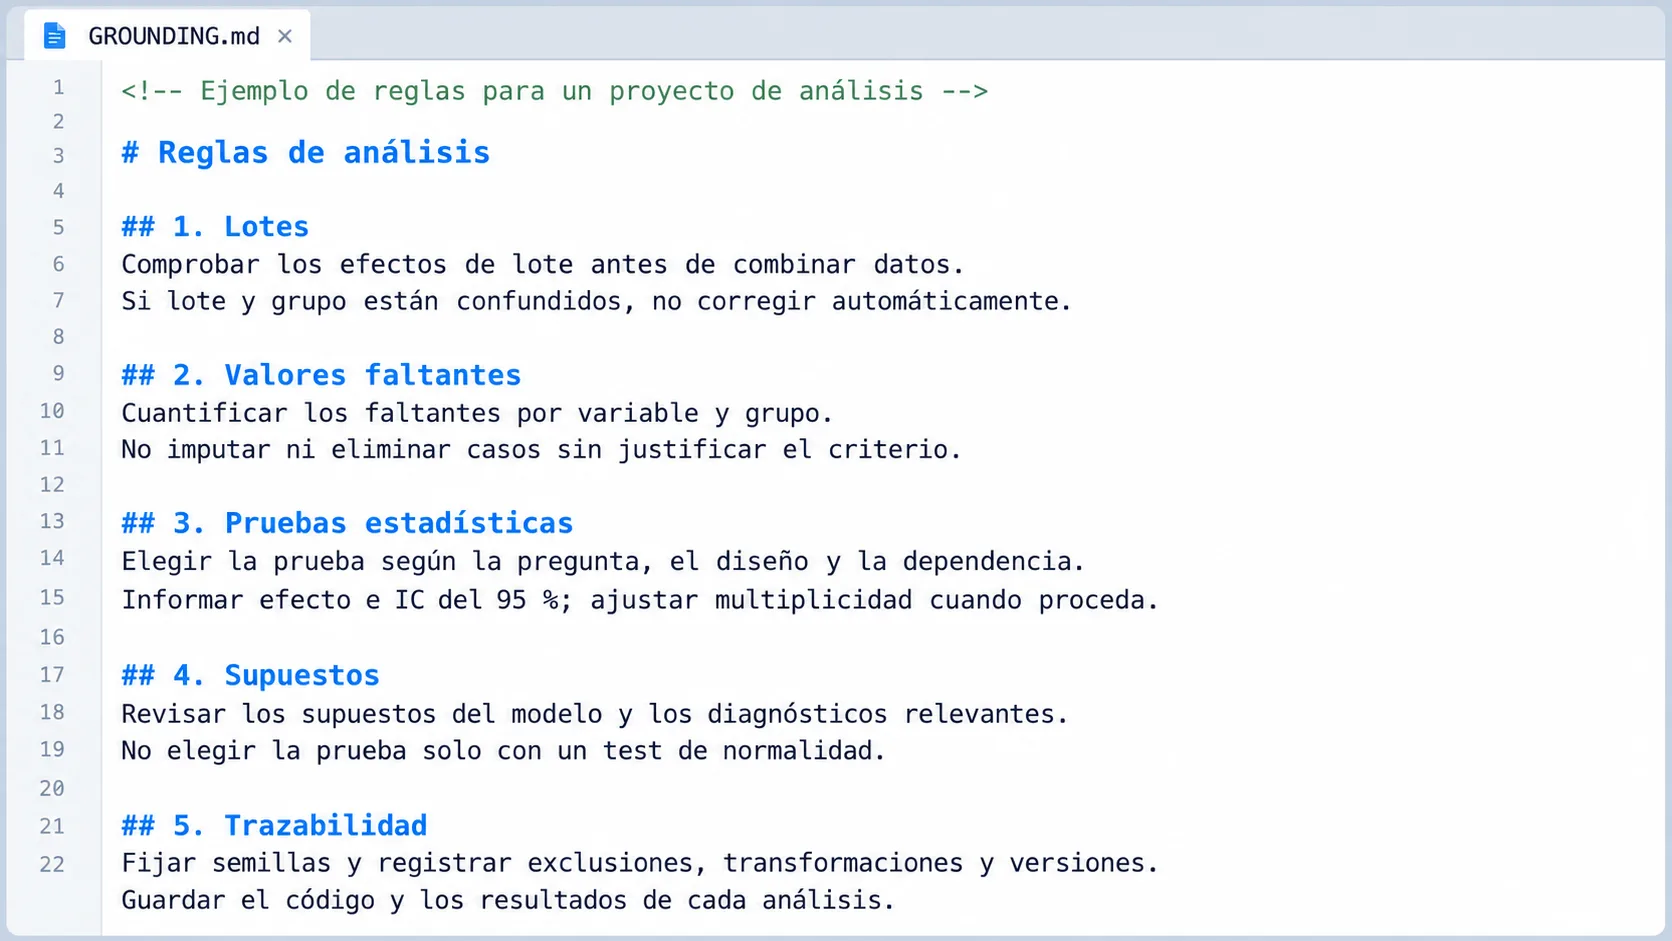
La literatura lo llama violar los invariantes epistémicos del dominio, es decir, las reglas que un bioestadístico aplicaría sin pensarlo y que el modelo desconoce si nadie se las dice. Las propuestas para evitarlo van justo por ahí: darle al agente, antes de que escriba una línea, un documento con las reglas del análisis. Palmblad y colaboradores lo llaman GROUNDING.md y lo plantean como un documento mantenido por cada comunidad científica. Ya han publicado uno sobre proteómica. Una regla de ese tipo podría ser, por ejemplo, «la imputación por vecinos más cercanos nunca cruza la frontera entre lotes experimentales». La otra pata es conectar los agentes con ontologías formales de herramientas y de formatos bioinformáticos.
En la síntesis de la literatura, el riesgo es similar. Las alucinaciones al resumir muchos documentos a la vez no son evidentes, sino plausibles y pseudocreíbles. Por ejemplo, una conexión entre rutas metabólicas que parece real pero no figura en ninguna de las fuentes. Las arquitecturas que mejor lo reducen combinan recuperación de información (RAG), agentes que descomponen la pregunta en subpreguntas y verificadores, pero ninguna lo elimina del todo, así que cada cita sigue necesitando a alguien que la compruebe.
Dónde están los datos
El Reglamento Europeo de IA iba a exigir en agosto de 2026 sus obligaciones para los sistemas de alto riesgo, pero el paquete Digital Omnibus, en vigor desde julio, las ha aplazado hasta diciembre de 2027 (y hasta agosto de 2028 para la IA integrada en productos regulados, como los productos sanitarios). Que se retrase no cambia mucho el fondo: el RGPD sigue ahí y, en la práctica, enviar historias clínicas o datos genómicos de pacientes europeos a servidores fuera de la UE para que un modelo comercial los procese ya era un riesgo legal difícil de asumir.
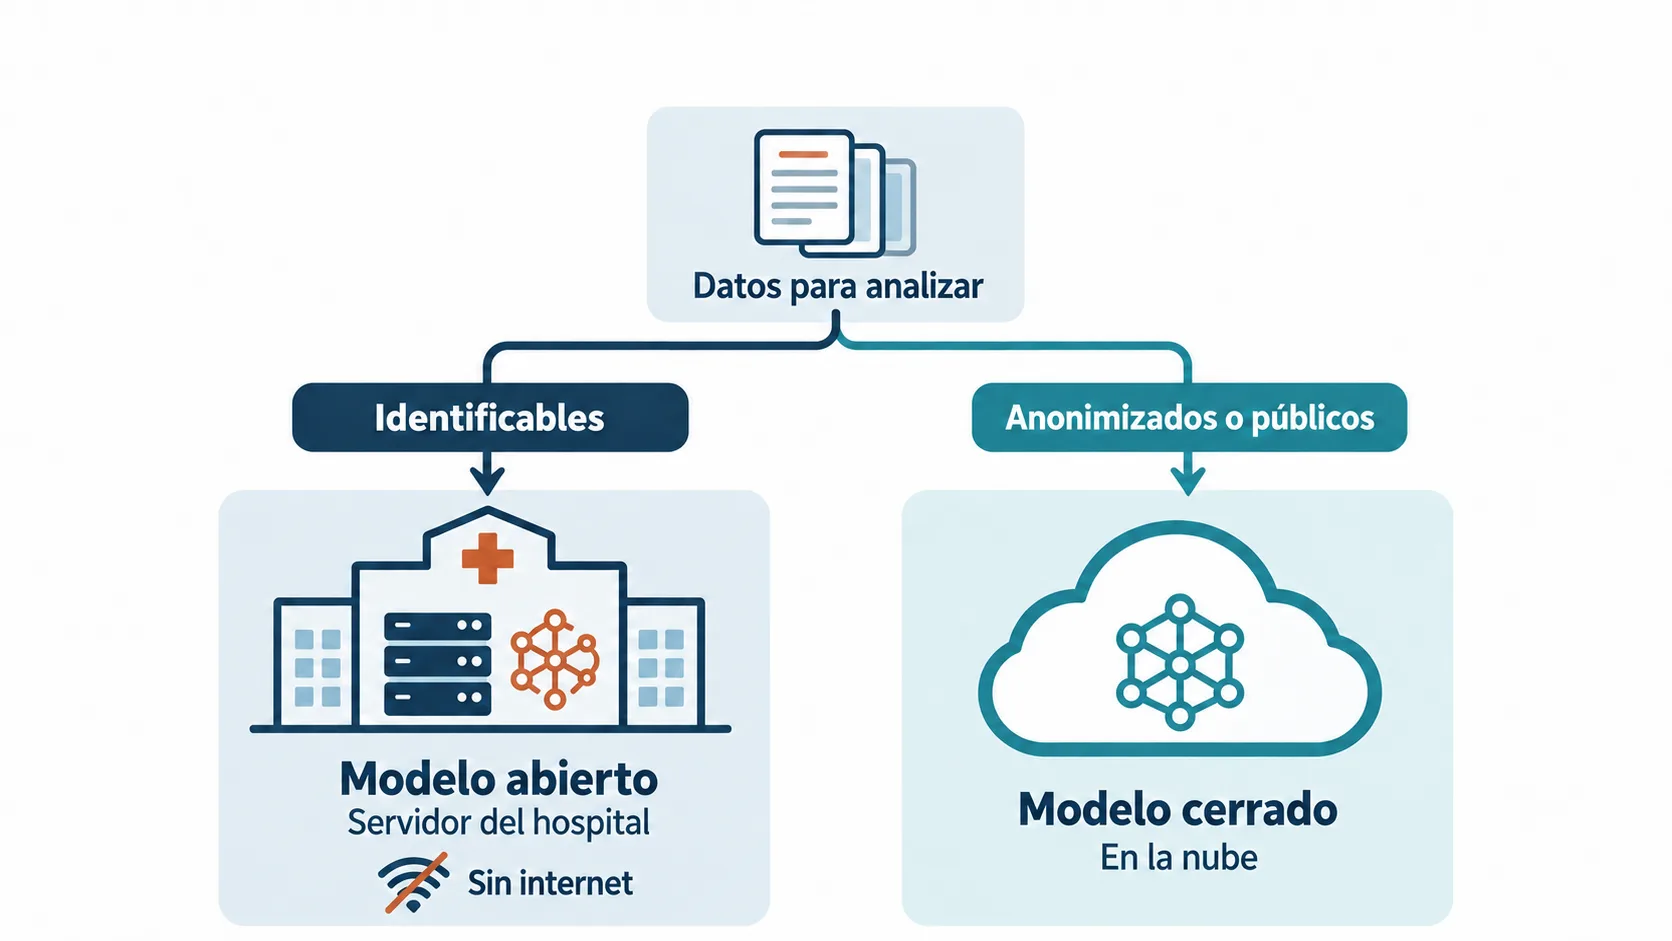
Aquí es donde los modelos de pesos abiertos pueden tener algo que decir, porque por primera vez se pueden instalar modelos competitivos dentro del perímetro del hospital, en máquinas desconectadas de internet. El coste se traslada al hardware: un ordenador de sobremesa con mucha memoria unificada basta para explorar con modelos cuantizados, pero para producción hacen falta clústeres de GPU (las versiones grandes de DeepSeek requieren más de ocho tarjetas de gama alta). A escala pública, infraestructuras como la ampliación de MareNostrum 5 en Barcelona ofrecen capacidad de cómputo bajo jurisdicción europea.
De ahí sale la propuesta que me parece más sensata: dejarse de elegir modelos y enrutar según la sensibilidad de los datos. En local, con un modelo abierto, todo lo que toque datos identificables (extracción de historias clínicas, secuencias con metadatos de pacientes) y en la nube, solo con datos anonimizados o públicos, lo que más se beneficia de los modelos cerrados: construir y depurar pipelines complejos o revisar literatura. No es una idea nueva ni es fácil de aplicar. Copilot GitHub intenta eso cuando automatizas el modelo según la tarea que le pidas y su calidad lo ha sufrido.
Mi humilde opinión
A ver, que nadie lea este post como un alegato en contra. Uso agentes a diario y no tengo planeado dejar de hacerlo, pero creo que nos están cambiando el trabajo de una forma que todavía no hemos asumido del todo. Escribir el script ha dejado de ser la parte difícil y lo que queda, decidir si el análisis tiene sentido, es justo lo que el agente no sabe hacer por sí solo. Nuestro criterio estadístico vale hoy más que hace dos años, porque es lo único que separa un resultado de una lista de falsos positivos bien maquetada.
Lo que me preocupa, en realidad, es quien empieza. Un estudiante de doctorado que nunca se ha peleado con un modelo mixto o de machine learning que no converge recibirá del agente uno que converge a la primera, sin saber si debía converger, y aceptará la tabla, la meterá en el manuscrito y lo publicará... Si está empezando su carrera académica, puede ocurrir que, 10 años después, alguien venga a recordarle su error y que deba pasar por una serie de situaciones que puedan poner en jaque su credibilidad profesional. Lo mismo se puede aplicar al resto de los firmantes de ese paper. La ética científica debe ser ejemplificada desde quien lidera o dirige el paper hasta quien lo realiza, si no queremos enfrentar consecuencias a largo plazo. Hay que tener en cuenta que hoy en día los errores se penalizan mucho más que hace unos años, cuando encontrar errores y fraudes podía ser algo circunstancial y los detectaban personas específicas con mucho conocimiento del tema. Hoy, ese tipo de búsquedas también las puedes programar desde tu agente y no necesitas ni el doctorado ni la experiencia.
Así que, si trabajáis con datos biomédicos, esto es lo que haría yo:
- Separad los datos antes que los modelos. Decidid qué puede salir de vuestro servidor y qué no, y elegid el modelo después. Tened en cuenta lo que establece el reglamento vigente, porque eso puede condicionar directamente vuestra elección.
- Escribid las reglas del análisis antes de pedir una sola línea de código. ¿Qué pruebas, qué supuestos, cómo se tratan los lotes y los valores perdidos? Un agente sin ese documento busca que el script se ejecute, no que sea correcto.
- Revisad la estadística, no solo el código, y comprobad cada cita en la fuente original, por muchos tokens que quepan en la ventana.
- Tratad las cifras de los fabricantes como trataríamos un ensayo financiado por el laboratorio que vende el fármaco: con interés y sin fe.
Y una última cosa, que tiene más de deseo que de consejo. El GROUNDING.md de proteómica lo ha escrito su comunidad. El de la epidemiología nutricional o el de la metabolómica no lo va a escribir nadie por nosotros. Si no ponemos por escrito las reglas que aplicamos sin pensar, los agentes las aprenderán de los papers ya publicados, errores incluidos, y eso será una deuda técnica que acabará por volver (si alguien se anima a empezarlo, ya sabe dónde encontrarme). Un script que compila no constituye un análisis correcto. Nunca lo fue, lo que pasa es que ahora es mucho más fácil olvidarlo.