¿Cómo la econometría de la elección aprendió a convivir con la diversidad de gustos? ¿Por qué la genética y las ciencias ómicas podrían, algún día, decirle de dónde proviene esa diversidad?
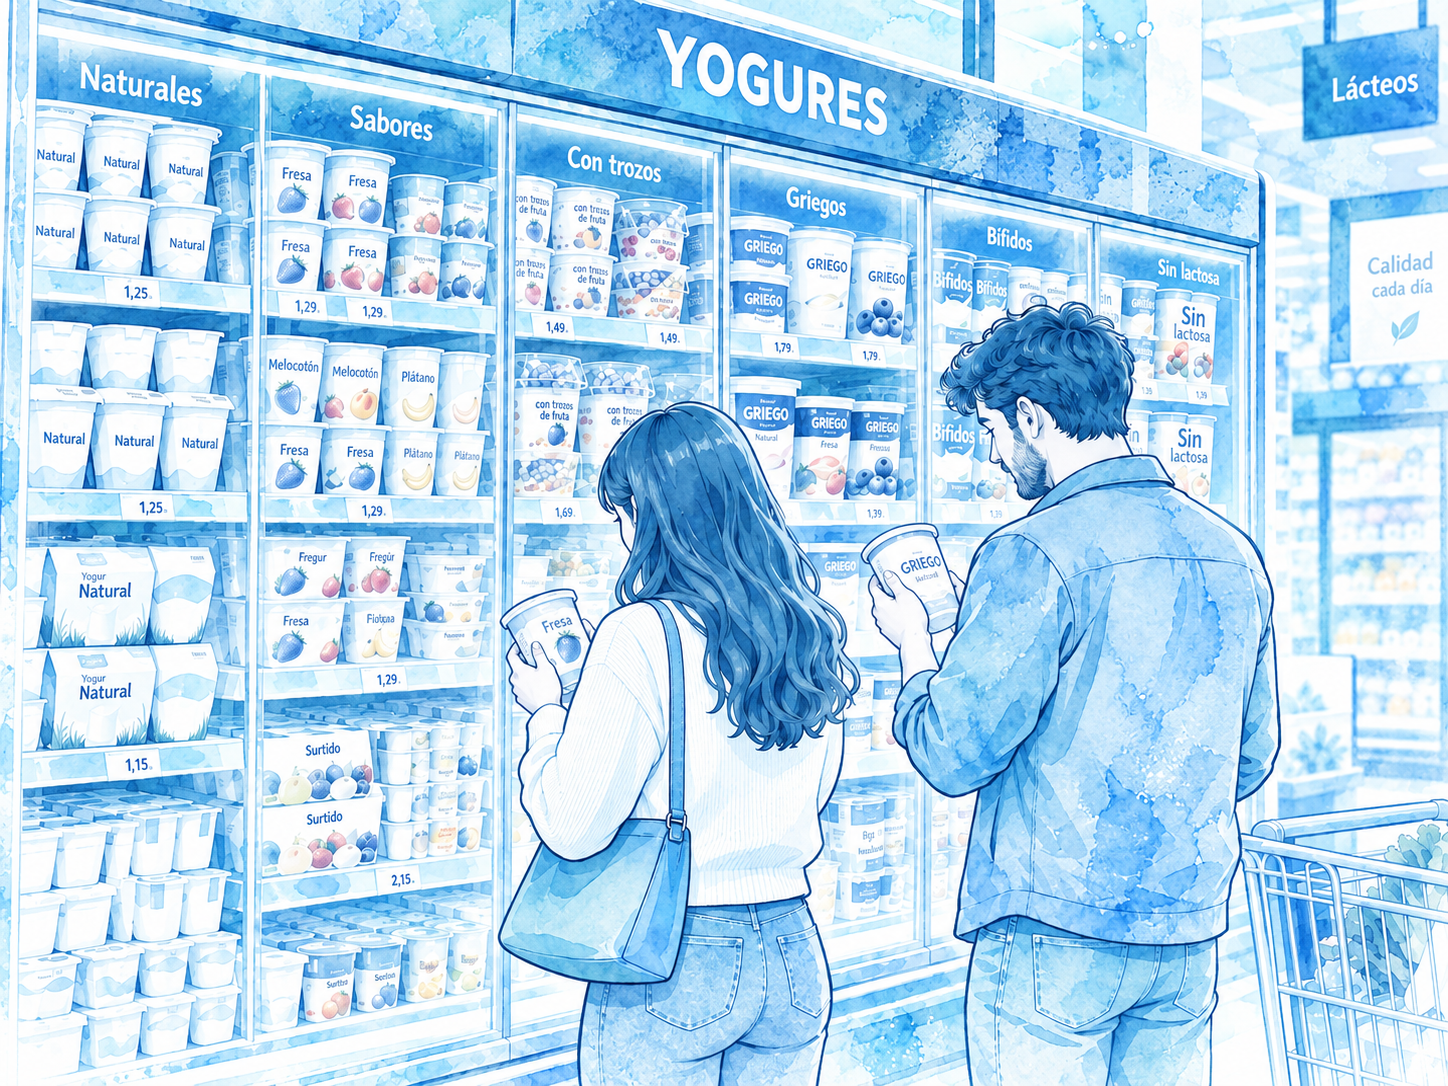
Dos personas se paran delante de la misma nevera del supermercado. Mismo yogur, misma etiqueta frontal de «bajo índice glucémico», mismo precio. Una lo mete en el carro sin pensarlo. La otra le echa un vistazo, lo deja en la estantería y coge el de al lado, más barato y sin sello. Si nos quedáramos con la media de estas dos personas, concluiríamos que el sello les importa a medias. Pero a ninguna de las dos le importa a medias: una lo compra y a la otra le da igual. Ese consumidor medio, el que lo valora todo a medias, no existe. Y, aun así, es lo que asume el logit multinomial clásico con un único coeficiente para toda la muestra y que es modelo de referencia en los estudios de preferencias alimentarias.
El modelo Logit con parámetros aleatorios (también llamado mixed logit o logit de coeficientes aleatorios) es, en el fondo, un intento serio de dejar de fingir que ese personaje existe (ese consumidor que quiere la mitad).
En el blog de esta semana voy a hablar de este modelo y sus diferencias con el anterior, y en qué contextos es importante tenerlo en cuenta.
Qué ha puesto el tema sobre la mesa
Podemos decir que, en las publicaciones epidemiológicas de los últimos tiempos, han convergido dos corrientes. Por un lado, los experimentos de elección discreta (DCE) se han convertido en la herramienta estándar para medir cómo elegimos la comida: qué peso damos al azúcar, a un claim nutricional, a un score nutricional, al origen o al precio. Cada vez que un gobierno discute un etiquetado frontal o una empresa reformula un producto, alguien está estimando preferencias con estos métodos. En un artículo de principios de año, por ejemplo, un DCE publicado en BMC Public Health, con 854 escolares chinos, usó un mixed logit para responder a la pregunta: ¿qué mueve la elección de aperitivos? Su respuesta general: los claims nutricionales, el sabor y la influencia social. Su respuesta más específica: había una alta variabilidad entre los niños.
Por otro lado, la nutrición de precisión ha convertido la heterogeneidad en su bandera. El estudio PREDICT 1, publicado en 2020 y con más de mil participantes, mostró que, aunque intentemos ser muy generales con las recomendaciones, en el fondo cada persona es un sistema independiente. En su caso, vieron que ante comidas idénticas, los niveles de triglicéridos y glucosa mostraban una tremenda variabilidad interindividual (del 103 % en los triglicéridos y del 68 % en la glucosa). Probablemente también exista una gran variabilidad intraindividual. No respondemos igual ni por dentro ni por fuera.
Pues bien, el modelo estrella para capturar esa diversidad en las decisiones lleva décadas afinándose en econometría y ahora la epidemiología le está dando trabajo nuevo.
Qué hace, sin la jerga
Todo arranca de una idea de Daniel McFadden que le valió el Nobel: cuando elegimos, escogemos la opción que nos da más utilidad, una utilidad que el investigador solo observa parcialmente. El logit clásico añade un supuesto cómodo, pero falso: que el peso de cada atributo (cuánto te disgusta el azúcar, cuánto te atrae un sello…) es el mismo para todos. De ahí se pueden extraer conclusiones claras, pero con gran probabilidad insuficientes, simplistas y, a términos generales, engañosas.
El logit con parámetros aleatorios permite corregir ese supuesto. En lugar de estimar un único coeficiente de precio, estima una distribución de coeficientes en la población, es decir, una media y una dispersión. El modelo permite que los gustos del consumidor varíen entre individuos, ofreciendo patrones de sustitución más realistas y aproximando el modelo a la elección más racional. En la práctica, te dice no solo «de media, la gente valora el sello X euros», sino también «para un 70 % lo valora positivamente y para un 30 % es indiferente o le molesta». La media deja de ocultar a la persona para mostrar una distribución porcentual en la que pueden caber diferentes supuestos.
Todo tiene un coste y estimarlo no se resuelve con una fórmula cerrada como en otros casos, sino que hay que hacer una aproximación con simulación, promediando muchos logits, lo que requiere mayor computación y una semilla para su reproducibilidad. Pero el premio es doble:
- Primero, la dispersión que obtenemos es información que te dice cuánta gente hay a cada lado.
- Segundo, puedes ir más allá y meter la heterogeneidad en la media del parámetro (lo que se llama heterogeneity in means), es decir, dejar que la valoración de un atributo dependa de la edad, el sexo, el nivel de renta… o, y aquí empieza lo interesante, de cualquier otra variable biológica.
Para qué sirve de verdad en investigación
Los usos concretos son tangibles. Por ejemplo, si volvemos al claim «bajo índice glucémico», en este artículo les permitió medir la disposición a pagar por yogur «bajo índice glucémico» y ver que su valor no podía establecerse de forma fija, sino que debería modularse según el conocimiento que tenía el consumidor sobre el claim y su interés en preservar su salud. En otro trabajo se usó para estimar cuánto pagarían los consumidores por etiquetas frontales evaluativas en salchichas. En cierto modo, lo que el modelo nos ofrece es la importancia relativa de cada atributo en una elección, su disposición a pagar, traducida en valor económico y, lo más valioso desde mi punto de vista, una guía de quién difiere de quién.
Esta guía nos permite modificar el diseño de las intervenciones. Si sabes que la aversión al precio se concentra en un segmento y la sensibilidad a los claims en otro, se pueden diseñar campañas para un segmento en vez de para un promedio que no compra nada.
Dónde conviene desconfiar
El modelo tiene límites y conviene tenerlos en cuenta.
- El primer limitante es que eliges tú la forma de la distribución. ¿El coeficiente del precio se distribuye como una normal, que admitiría gente a la que le gusta pagar más, o como una lognormal, que fuerza el signo pero deforma la cola? Esa decisión no es sencilla y su elección puede modificar sustancialmente las estimaciones de disposición a pagar. El modelo no tiene capacidad para descubrir la heterogeneidad, sino que depende del molde (la distribución) que le estás indicando que debe seguir.
- El segundo limitante que debemos considerar: un mixed logit puede atribuir a «gustos variados» lo que en realidad es gente que ignora ciertos atributos al decidir (attribute non-attendance), es decir, interpretar la ignorancia o el desinterés como aleatoriedad en la decisión. No tener esto en cuenta puede inflar las estimaciones de bienestar.
- Y el tercer limitante que todo DCE sufre: lo que la gente dice en una encuesta no siempre se transfiere a la caja. Las preferencias declaradas y las reveladas no coinciden. El modelo es exquisito al modelar lo primero, pero con lo segundo requiere cierta humildad por parte del/la investigador/a.
Considero que el parámetro aleatorio es una elegante confesión de ignorancia que te cuantifica cuánto diferimos, pero deja en la oscuridad por qué, y hay que añadirle que la distribución es una caja cerrada que desconocemos y que nunca sabremos cuál es realmente, porque nunca tendremos toda la información necesaria.
El puente con las ciencias ómicas
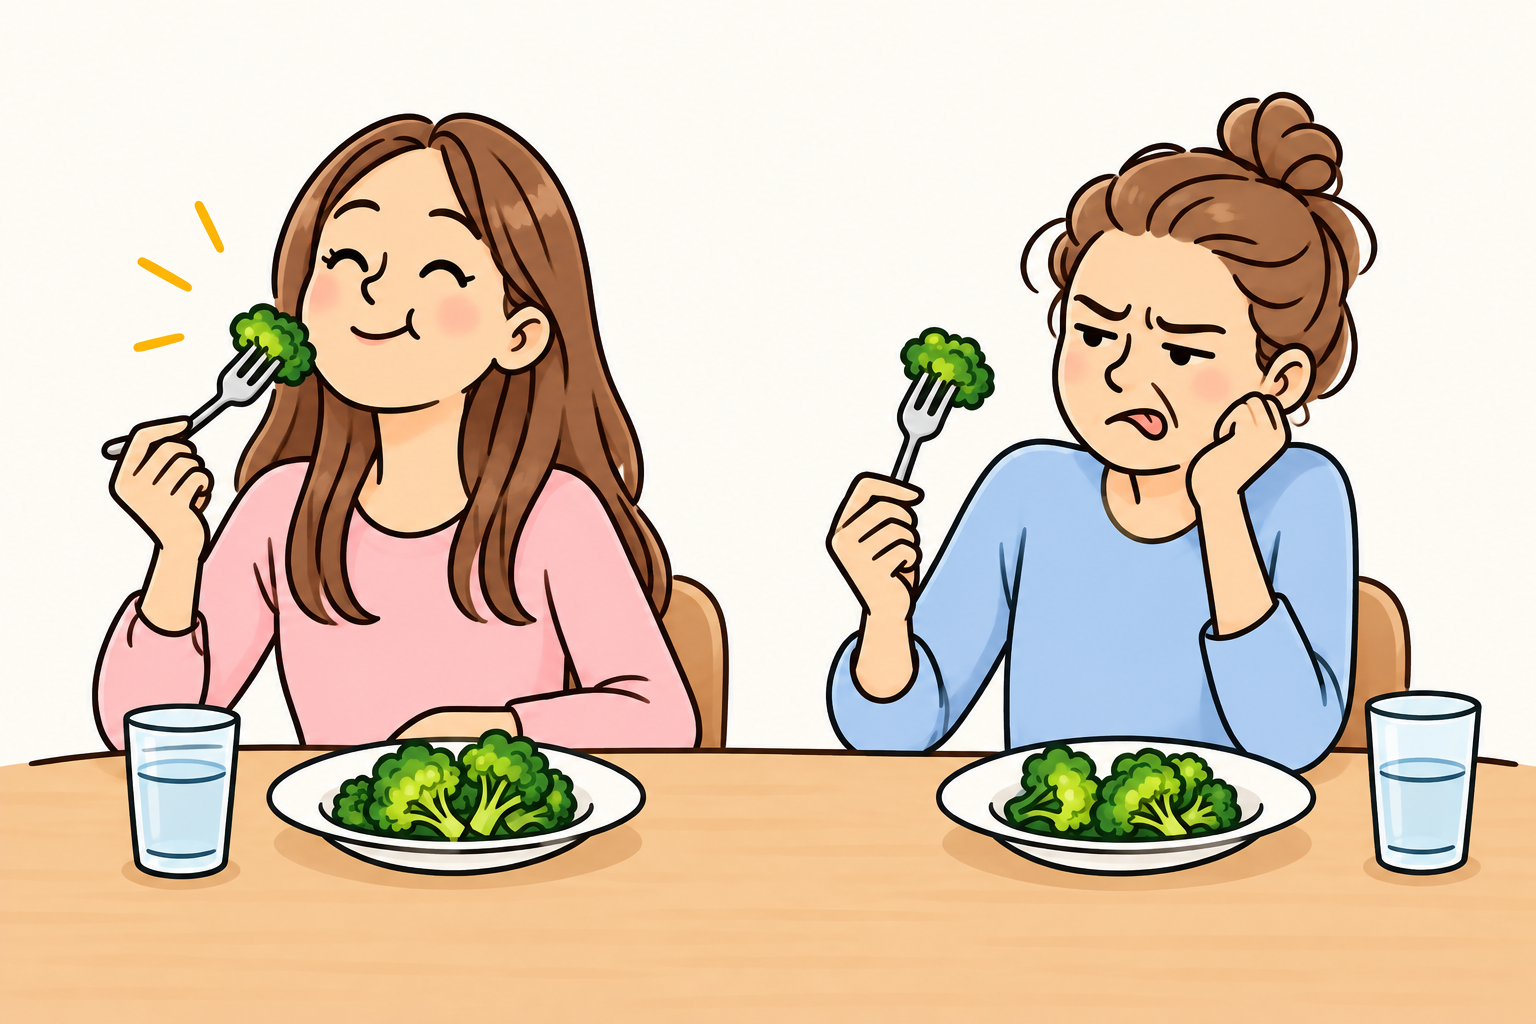
Volviendo a la nutrición de precisión, sabemos que buena parte de cómo respondemos a la comida tiene un componente biológico, y hay quien propone ordenar el campo por escalones: primero la precisión por fenotipo, después por ómicas (subgrupos que comparten una misma biología) y, al final, la integración de ambas. Si la biología condiciona cómo respondemos a un alimento, es razonable pensar que también condiciona cómo lo valoramos. El logit con parámetros aleatorios permite comprobarlo. En este modelo cada persona tiene su propio coeficiente para cada atributo y se estima cómo se distribuyen esos coeficientes en la muestra. Hasta ahora, esa dispersión se quedaba como una heterogeneidad sin explicación. Si añadimos variables ómicas como covariables, el centro de la distribución se desplaza según el perfil biológico de cada persona y la heterogeneidad no observada se vuelve, en parte, observable. Por ejemplo, el gen TAS2R38 codifica uno de los receptores del gusto amargo. Se ha publicado que las variantes que embotan la percepción del amargor se asocian con un mayor consumo de verduras crucíferas (el brócoli le sabe menos a quien no percibe esos compuestos). ¿Y si se hiciera un DCE sobre verduras en el que el coeficiente de «amargor» fuera un parámetro cuya media dependiera del genotipo del participante? Estaríamos abriendo la caja negra.
También tengo que ser honesto y escéptico (la maldición del investigador). Casi nadie ha hecho esto y en el ejemplo anterior se usan modelos mixtos basados en la ingesta declarada. Al menos hasta ahora, no he encontrado un DCE con parámetros aleatorios acoplado a perfiles ómicos individuales. También debemos considerar que los efectos genéticos individuales suelen ser modestos: en el propio PREDICT, las variantes genéticas explicaban una fracción pequeña de la varianza glucémica y lipídica, muy por debajo de la del microbioma. Un metabotipo o una firma metabolómica probablemente informe mejor la elección que un puñado de SNP y conviene resistir la tentación comercial de usar un test de saliva que no «explica» tus decisiones alimentarias. Venderlo como si lo hiciera (que ya se hace) es determinismo de laboratorio.
¿Y esto a mí, qué?
Por ir acabando. Los mensajes operativos que me gustaría dejar son:
- Hay que reportar la dispersión, no solo la media, porque el promedio es justo donde no vive nadie. El coeficiente aleatorio es, en el fondo, una forma estadística de humildad: admite que no sabe por qué diferimos y se limita a medir cuánto.
- También hay que preregistrar qué distribución vas a asumir en vez de elegirla después de ver qué sale.
- Si puedes, diseña tus experimentos de elección con recogida de muestras biológicas, de modo que, si llega la oportunidad, puedas analizarlas y obtener información biológica (genética, metabolómica o del microbioma) que ayude a explicar por qué se toman ciertas decisiones.
Combinar la preferencia declarada con los biomarcadores es una frontera que este modelo permite explorar, aunque aún casi nadie la aprovecha.
Y si solo intentas comer mejor, hay una lección útil escondida en la econometría: el consejo genérico «come más verdura» falla no porque estés desmotivado, sino porque tu curva de utilidad no es la media. A ti puede que el brócoli te sepa distinto que a tu vecino.