Qué pueden y qué no pueden hacer las firmas metabolómicas de la ingesta
Preguntarle a la gente qué come es, todavía hoy, el método estándar para medir la dieta en epidemiología nutricional. Funciona razonablemente bien para algunas cosas y tremendamente mal para otras. Llevamos cuarenta años arrastrando los mismos problemas: la gente no es precisa con su consumo real de alimentos. Suelen infraestimar las calorías, sobreestimar la fruta y la verdura y rara vez se acuerdan de qué han picoteado entre horas. La alternativa de la que se ha hablado desde entonces es la misma. ¿Se puede estimar el consumo de alimentos en la sangre o en la orina a partir de las huellas químicas que deja la comida? La respuesta corta, ahora mismo, es no. Sin embargo, parece que ya hay modelos publicados con validación y métricas que permiten discutir esta negación tajante con datos.
En 2025, el grupo de Erikka Loftfield publicó en PLoS Medicine un análisis de más de mil metabolitos en suero y orina de 718 participantes del estudio IDATA, con hasta seis recordatorios dietéticos a lo largo de un año. Con una regresión LASSO seleccionaron 28 metabolitos en suero y 33 en orina de 24 horas y construyeron puntuaciones multimetabolito de consumo de ultraprocesados con ellos. Diría, en este punto, que nada nuevo en lo que se publica últimamente, casi cada mes. Fueron un paso más allá y comprobaron si esas puntuaciones cambiaban al variar la alimentación, en este caso mediante un ensayo cruzado de alimentación controlada en veinte personas ingresadas en el NIH: dos semanas con el 80 % de la energía en forma de ultraprocesados y dos semanas con el 0 %. Efectivamente, las puntuaciones diferían en el mismo individuo según la fase. Ya tenemos un punto en el que la ingesta es conocida y controlada.
Otro trabajo con 8.391 participantes de tres etnias asiáticas, 1.055 metabolitos plasmáticos y 169 alimentos y bebidas obtuvieron paneles multibiomarcador reproducibles al repetir las mediciones con el tiempo y predecían resistencia a la insulina, diabetes, IMC e hipertensión mejor que el autorreporte de los mismos participantes.
De la molécula única al modelo
La base de esta idea es lo que conocemos como el food metabolome. La comida está formada por compuestos químicos que se absorben, se transforman en el tubo digestivo y acaban circulando o eliminándose. Algunos de estos compuestos son conocidos como xenobióticos: moléculas exógenas al organismo y que es incapaz de fabricar (al menos en cantidades suficientes como para considerarlos propios). Otros son metabolitos endógenos cuya concentración varía con la dieta.
Durante años se buscó el biomarcador específico, un compuesto presente en los alimentos. Tenemos, por ejemplo, la prolina betaína en la orina de los cítricos, la trigonelina en el café, la anserina en las carnes y los pescados, y así unos cuantos más que, en cantidades sustanciales, se consideran procedentes del consumo de alimentos. Lo normal no es eso. Más ejemplos, en un ensayo cruzado con kiwis, de los 23 metabolitos urinarios que aumentaban tras el consumo, casi ninguno era exclusivo del kiwi. Optaron por cambiar el enfoque y, con un modelo XGBoost basado en siete metabolitos, clasificaron a los consumidores con una exactitud de 0,88. Con el aceite de oliva también pudimos observar algo similar. Encontramos 78 metabolitos asociados al consumo de aceite de oliva virgen, con una correlación de 0.40. Más allá del aporte clínico, lo que se evidencia es que el cuestionario, por sí solo, no resulta suficiente.
El instrumental estadístico no es nada exótico y es el mismo que usamos para otras firmas: modelos supervisados para seleccionar entre miles de variables correlacionadas y réplica en una cohorte independiente. En un trabajo que publicamos este año sobre firmas metabolómicas de diabetes tipo 2 y resistencia a la insulina, la arquitectura era esa. Lo que cambia es la variable dependiente y en lugar de un fenotipo metabólico, se usa como etiqueta una exposición dietética. Sin embargo, hay limitaciones. Ni más ni menos que las limitaciones incluidas en los métodos de recogida de datos de alimentación, que requieren un trabajo de catalogación poco visible y no tan extendido: los diccionarios alimento-moléculas. Un estudio comparó el perfil del salmón con el de otros 99 alimentos de una dieta mediterránea e identificó 508 compuestos presentes únicamente en el salmón. 143 aparecieron posteriormente en plasma. Sin ese diccionario alimento-molécula, los modelos no tienen de dónde partir.
¿Sustituiría al FFQ o al registro de tres días?
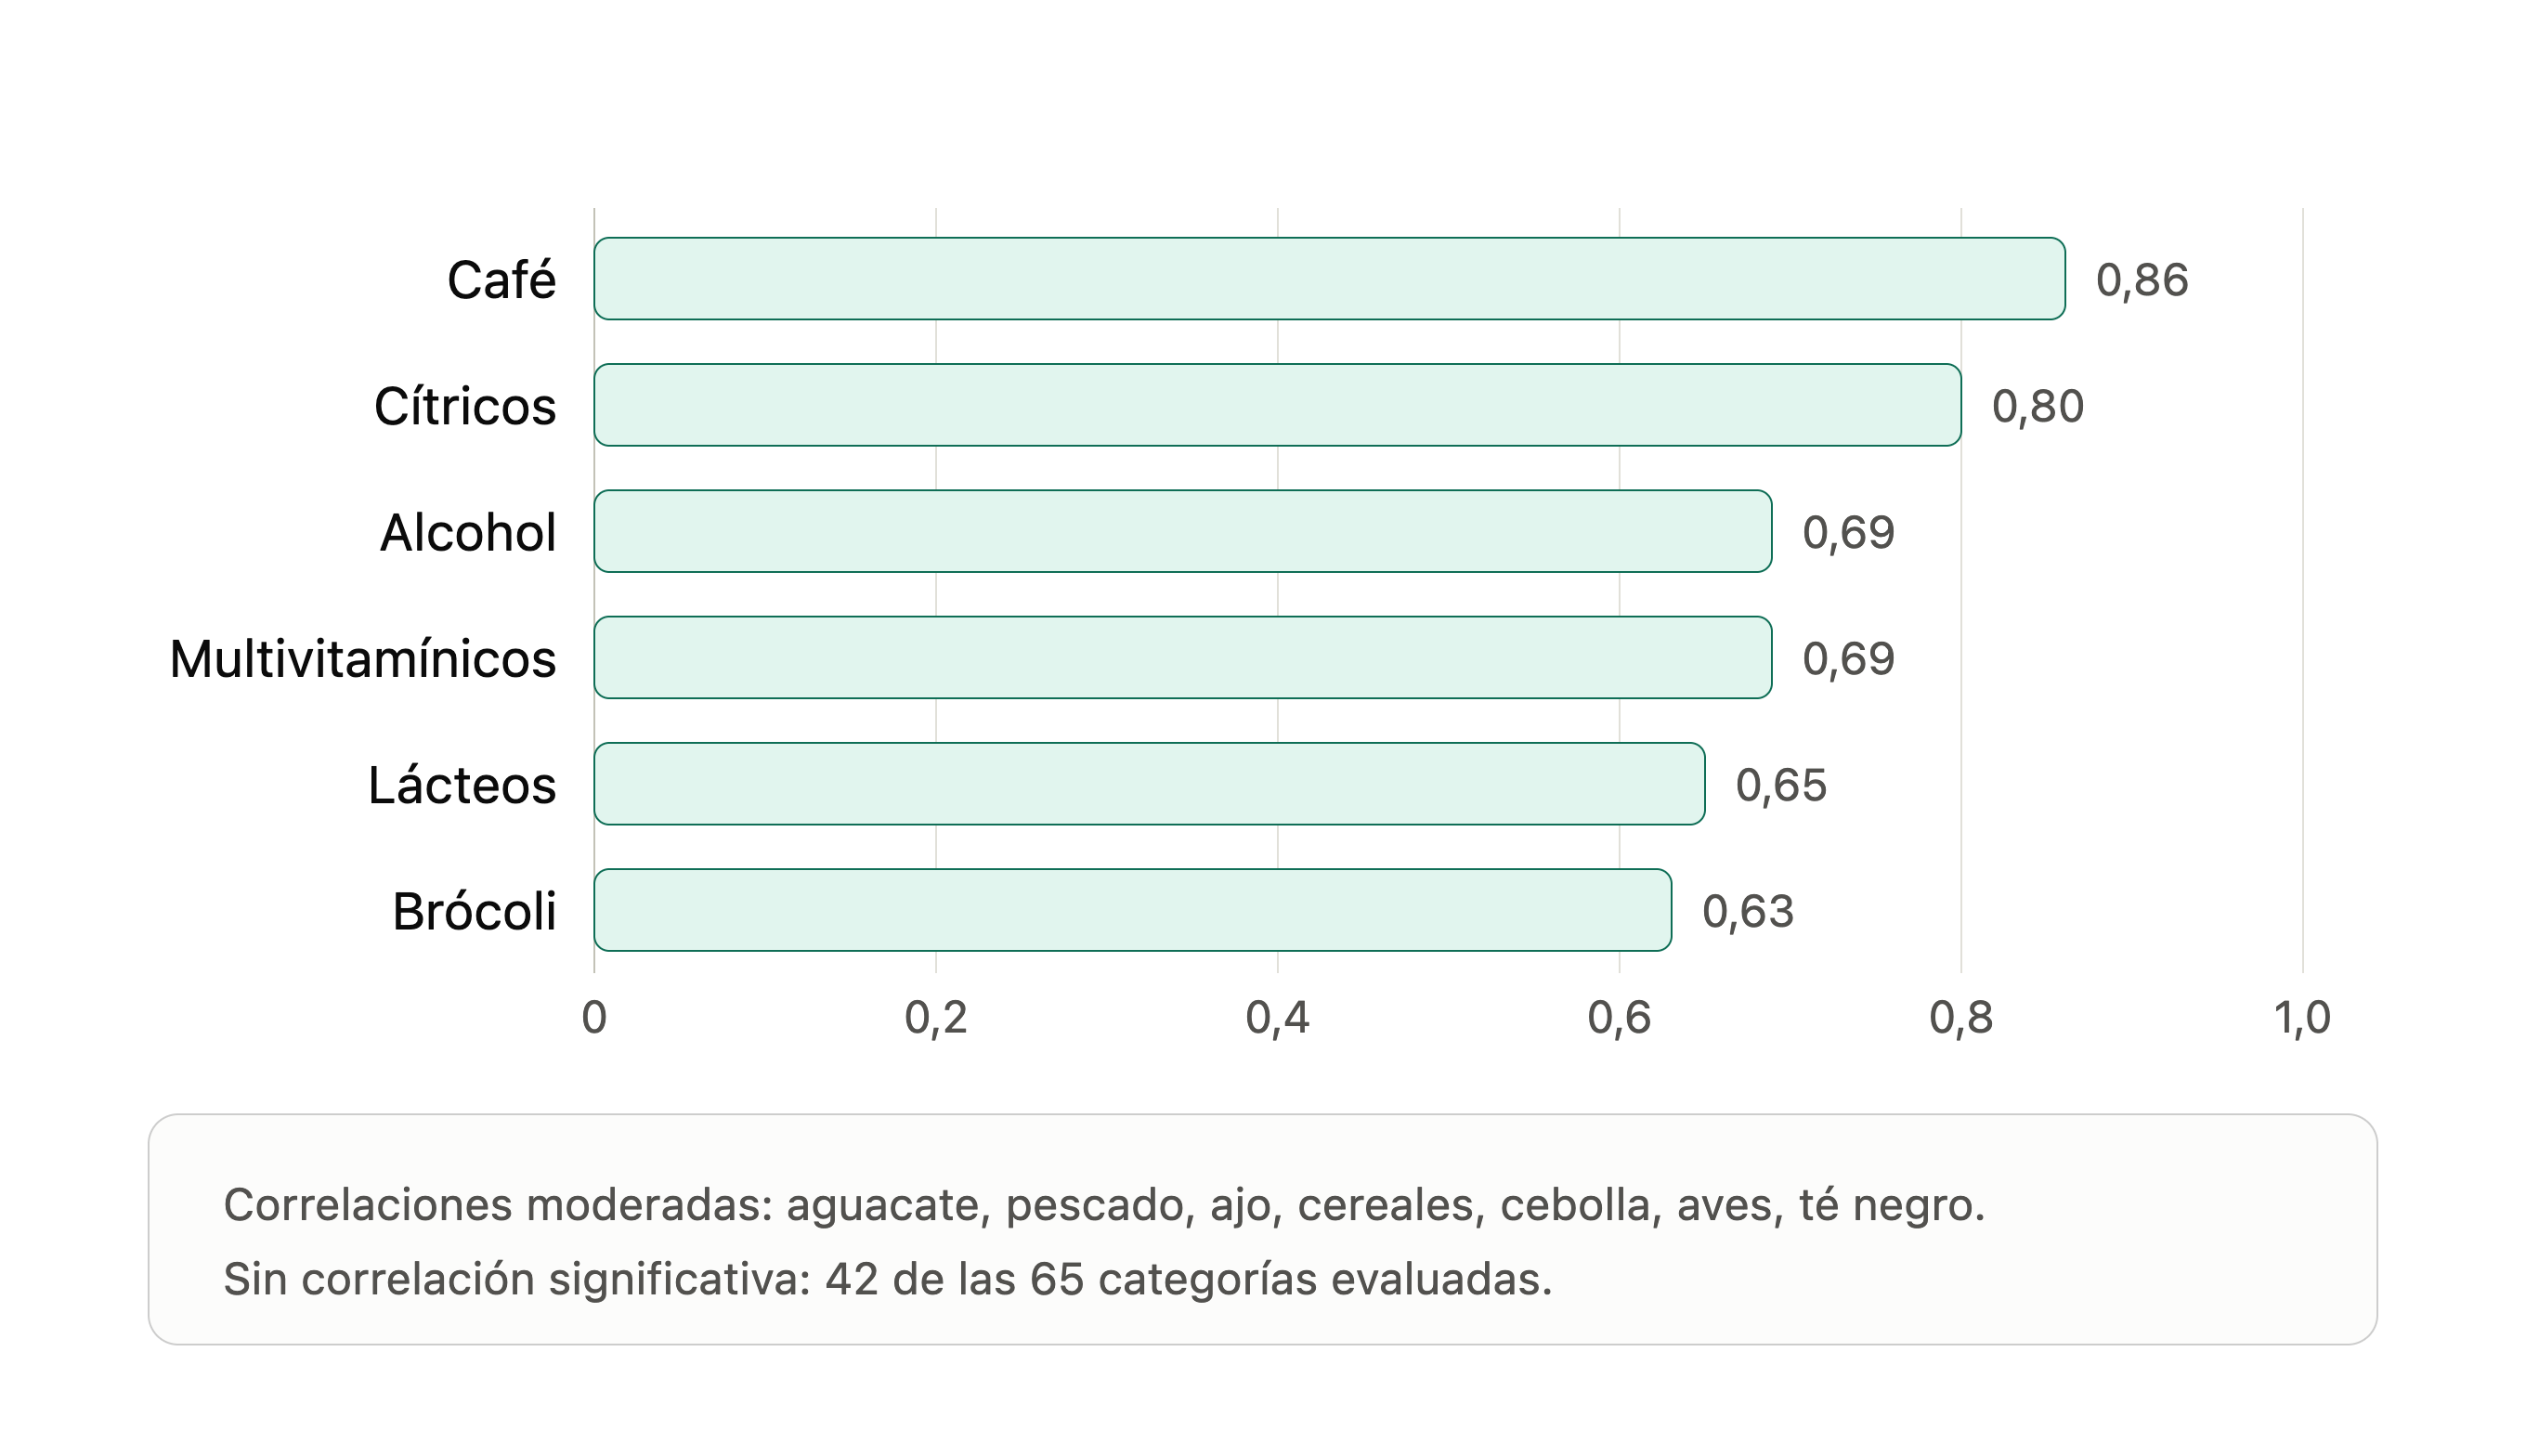
Con la evidencia disponible, no. Y conviene detenerse en el porqué, porque el matiz explica bastante el campo. Lo que normalmente nos encontramos es que a pesar de tener controlada la alimentación, siguen existiendo dificultades para encontrar patrones característicos que permitan diferenciar los alimentos, al menos al visualizarlos por separado. De hecho, normalmente, hay grupos de alimentos que sí se caracterizan bien, especialmente el café, los cítricos, los lácteos o el alcohol, pero otros, como las verduras, las frutas o los pescados, pueden ser tan heterogéneos o tener un impacto nutricional tan pequeño que pueden alterar prácticamente todo el metabolismo, o, al revés, apenas tocarlo.
En este estudio, por ejemplo, de 65 alimentos, bebidas y suplementos evaluados, solo 23 mostraron correlaciones significativas. Para los otros 42 no hubo señal.
En general, los alimentos que funcionan bien contienen compuestos específicos que no se encuentran en otras fuentes. La metabolómica detecta bien esos marcadores idiosincrásicos, pero cuantifica mal las categorías difusas (carne roja, grasas añadidas, raciones de verdura), justo donde el cuestionario también falla y donde se juegan las recomendaciones.
También debemos tener en cuenta las limitaciones del análisis ómico como la logística, que casi nunca aparece en la discusión. Recoger sangre, orina de 24 horas o heces no tiende a ser más cómodo que rellenar un cuestionario. Más bien es al revés. Un perfil no dirigido de mil metabolitos cuesta varias órdenes de magnitud más que usar unos folios, no está estandarizado entre laboratorios y arrastra efectos de lote que complican la comparación entre estudios. Fenotipar a medio millón de personas no es una opción realista.
El escenario que sí tiene sentido es el de la calibración. Se podría utilizar un subestudio con biomarcadores en una cohorte grande y aplicar una corrección del error de medición del cuestionario en el conjunto a partir de dicho subestudio. Es el mismo esquema que ya se usa con el agua doblemente marcada para energía y con el nitrógeno urinario para proteína, pero ampliado a más alimentos.
Qué mejoraría en la investigación
El interés en desarrollar estos modelos no consiste en adivinar menús, sino en reducir la atenuación. Cuando la exposición se mide con error, el coeficiente estimado tiende a acercarse a cero y el intervalo se ensancha. Eso significa que existen asociaciones reales que pierden significación, se calculan tamaños muestrales desproporcionados (y por lo tanto, no éticos) y se genera literatura que replica cada vez peor los hechos de la realidad. Parte de la mala fama de la epidemiología nutricional procede precisamente de estas fallas.
Hay otros usos más inmediatos. Por ejemplo, medir la adherencia en ensayos dietéticos sin depender de diarios rellenados a posteriori, comparar cohortes de distintos países con una métrica que no dependa de cómo redactó cada equipo su cuestionario y uno que suele pasarse por alto, que los metabolitos que seleccionan estos modelos no sean solo marcadores de exposición, sino también candidatos a mediadores. Si una molécula aumenta con el consumo de ultraprocesados y, además, aparece en firmas asociadas a enfermedad hepática, podemos desarrollar una hipótesis mecanística contrastable.
Qué haría falta para que llegara a la clínica
Para que una prueba entre en consulta, tiene que cambiar una decisión y traducirse en un desenlace mejor. Ese ensayo no está hecho.
Ahora mismo, podríamos medir el metaboloma, estimar con el modelo que el paciente consume más ultraprocesados de los que declara, comunicárselo y, a partir de ahí, nada. No hay evidencia de que confrontar a alguien con un biomarcador de su propia dieta mejore su alimentación. Podría funcionar como efecto espejo, de forma similar a lo que se describe con la monitorización continua de la glucosa en algunas personas, o podría no hacer nada. Es una pregunta empírica pendiente.
El nicho con recorrido a corto plazo es más modesto. Se podría verificar la adherencia cuando la decisión clínica depende de ella y no hay manera de distinguir el fracaso terapéutico del incumplimiento. En cierto modo, el valor no estaría en diagnosticar, sino en complementar una decisión clínica.
El terreno comercial
Es previsible que esta parte avance más rápido que las anteriores y no porque la evidencia sea mejor. Los precedentes están documentados. El mercado está lleno de test nutrigenéticos con un coste medio de 200 euros (os sugiero leer esta revisión). Solo el 54 % de las empresas hacen públicos los genes que utilizan y, de momento, el mercado no cuenta con una regulación específica. En el caso del microbioma, muchas de estas compañías declaran que sus tests no son diagnósticos mientras su publicidad sugiere una precisión y una relevancia médica que no están demostradas.
Los modelos de negocio posibles para una herramienta que estima la dieta a partir de la sangre son básicamente tres:
- El de venta directa al consumidor, con informe y suscripción.
- El B2B de verificación de la adherencia para ensayos clínicos y la industria alimentaria (el uso más defendible desde mi punto de vista).
- Y el de seguros y programas corporativos de bienestar, que es el que plantea más problemas: una prueba biológica que estima qué come alguien también sirve para que un tercero lo compruebe.
El contexto regulatorio no ayuda: en 2025 la FDA retiró la norma que clasificaba los tests desarrollados en laboratorio como productos sanitarios sujetos a su supervisión, de modo que la brecha entre publicar un modelo y comercializarlo es menor de lo que sería deseable.
Una precisión final
Ninguno de estos modelos responde exactamente a la pregunta que parece responder. No estiman qué ha comido una persona, sino cuánto se parece su metaboloma al de quienes declararon haberlo comido. La diferencia en la redacción es pequeña, pero considerable.
Conviene tenerlo presente al leer las cifras. La validación que sustenta el trabajo más citado del campo se realizó con 20 personas de 18 a 50 años, mientras que el modelo se había entrenado con adultos de 50 a 74 años. Y cuando los modelos generativos actuales intentan identificar un pico desconocido del espectro, aciertan en primera posición el 55,9 % de las veces sobre espectros de librería y el 68,5 % sobre espectros de muestras biológicas reales: una mejora notable respecto a las herramientas anteriores y, al mismo tiempo, un error de uno de cada tres (MetGenX, Nature Communications 2026). Son datos suficientes para tomarse el campo en serio y también para no tratar estas firmas como una medida directa de lo que hay en el plato.
¿Y las redes neuronales?
Todo lo anterior describe firmas construidas alimento a alimento. Cabe plantear la vuelta completa: ¿por qué no entrenar un modelo multitarea —una red con representación compartida y una salida por grupo de alimentos— que devuelva un cuestionario completo a partir del metaboloma? No treinta modelos independientes, sino uno que aproveche que los alimentos comparten metabolitos, porque los polifenoles, las acilcarnitinas o los lípidos de cadena par aparecen en varias exposiciones a la vez y ahí una representación común regulariza mejor que treinta ajustes por separado. Y, ya puestos, entrenarlo sobre la matriz completa de picos m/z-tiempo de retención, en lugar de entrenarlo sobre los metabolitos conocidos.
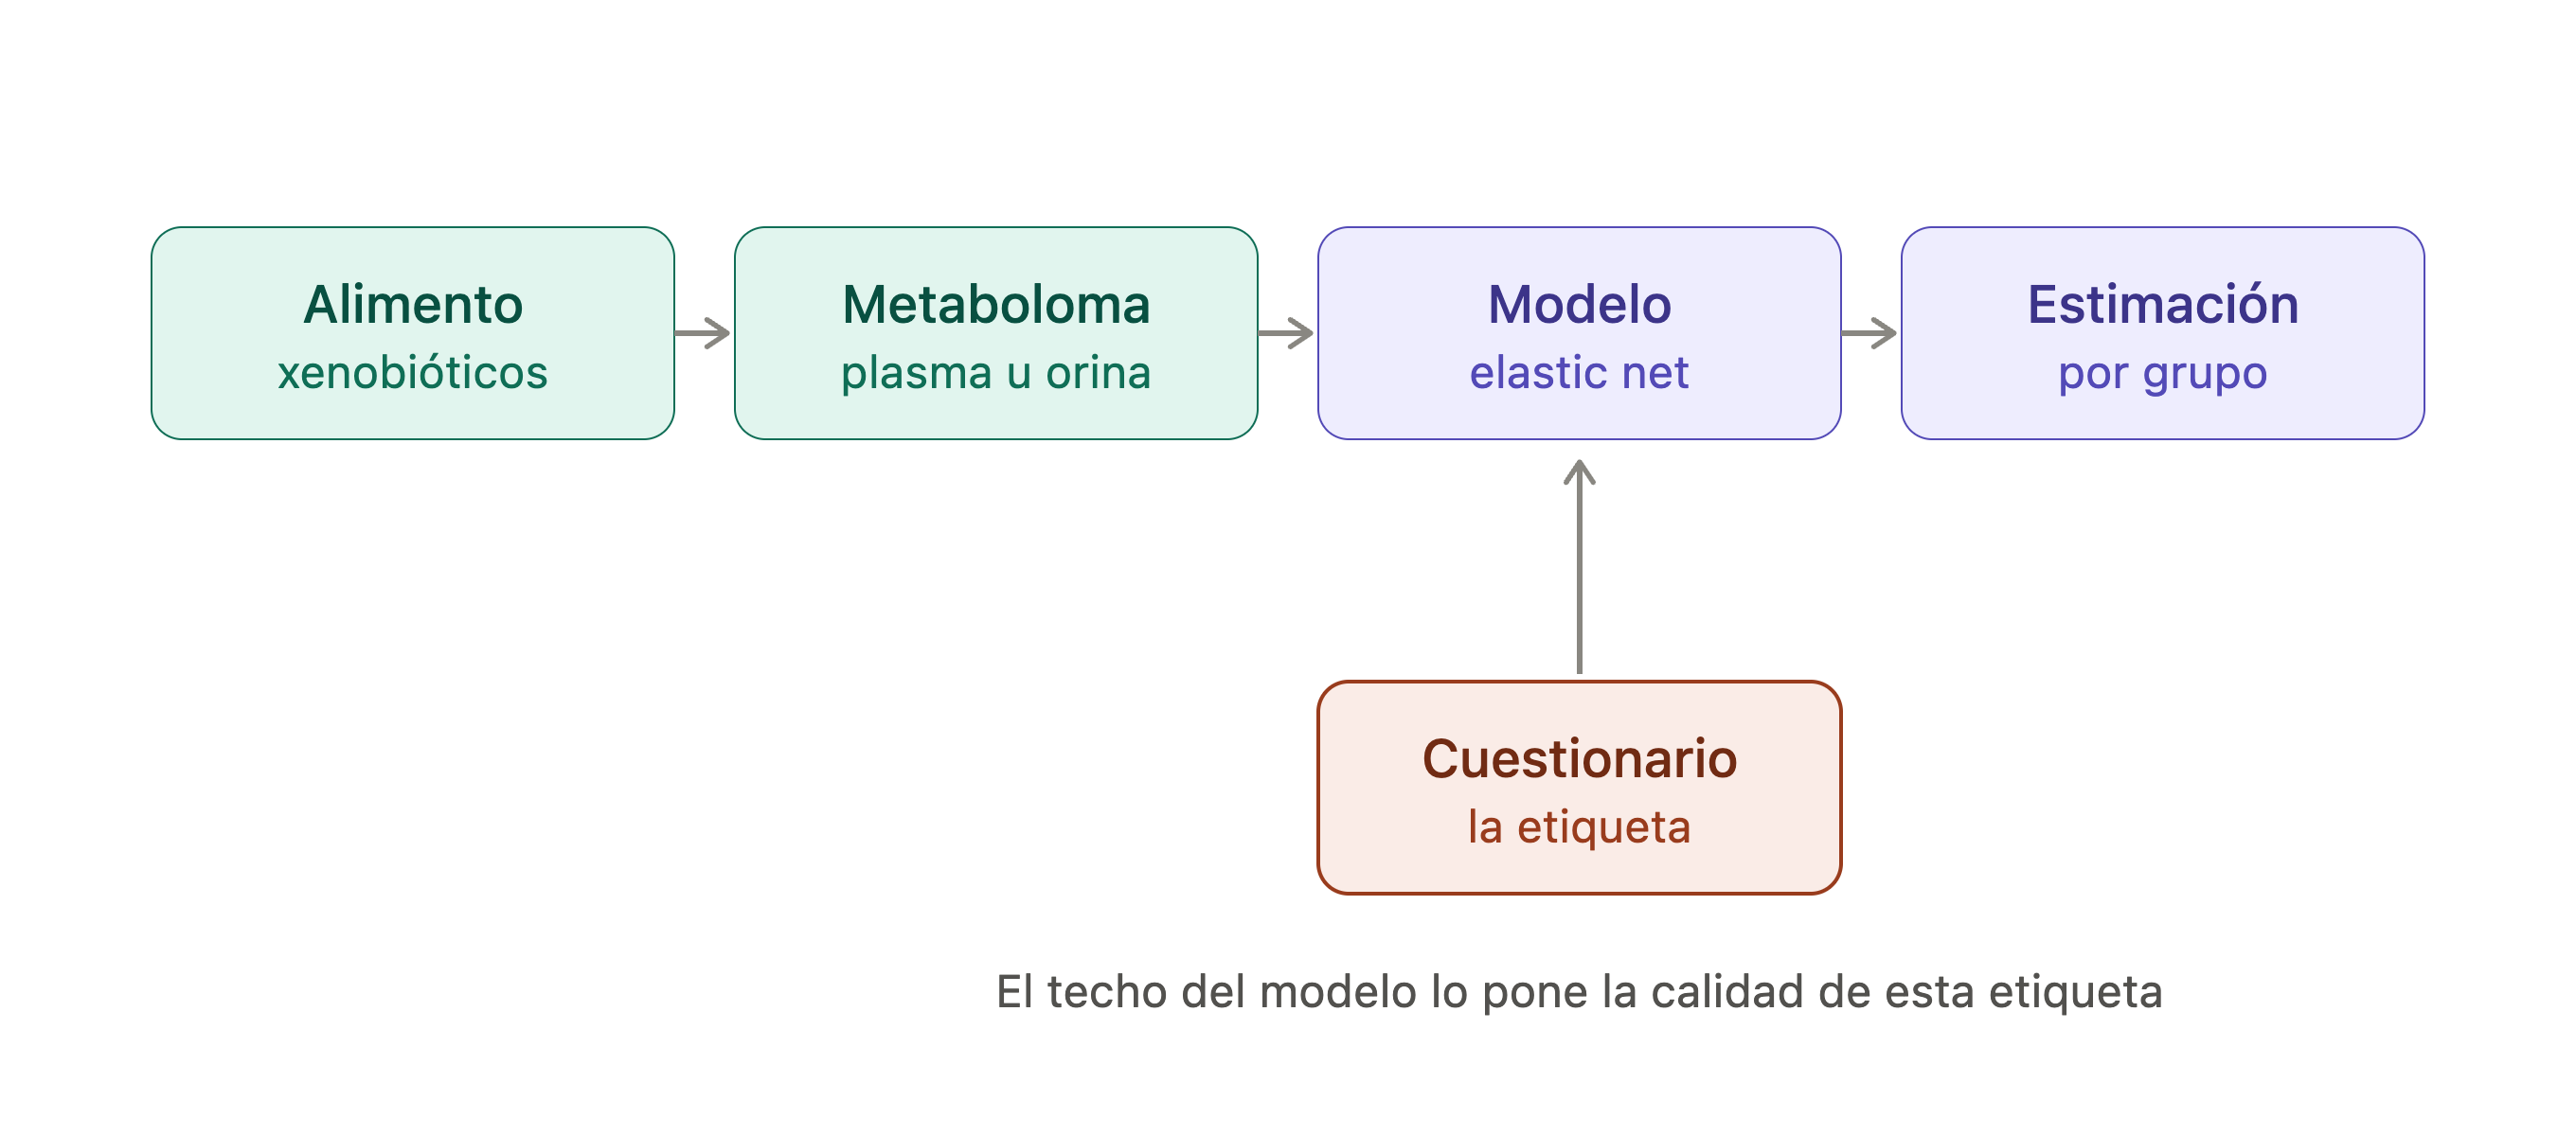
En este caso, el obstáculo no sería el modelo, sería la etiqueta. Si entrenas contra un cuestionario, el techo lo pone la fiabilidad de ese cuestionario, y una red con más capacidad no aprende mejor la dieta, aprende el ruido y el sesgo de declaración. Haría falta entrenar contra ingesta pesada con precisión o contra recordatorios repetidos, comparar y validar contra modelos de machine learning, separar los folds por lote analítico y por centro, y reportar el rendimiento alimento a alimento en lugar de un R² global. Habría otro inconveniente (quizá el más crítico): la mayoría de las cohortes con decenas de miles de participantes se midieron por RMN, que es casi ciega a los xenobióticos, y las que tienen espectrometría de masas cuentan con pocos miles de sujetos. Hasta donde sé, casi parece que se requiere más trabajo de negociación que científico para llevar un proyecto así adelante.